一、先把话说在前面
最近一段时间,常有人拿三种 Agent 来问我。Code Agent、通用办公 Agent、Data Agent,不都是大模型在调工具吗?循环看起来一样,能力看起来也重叠。更直接的一问是:Code Agent 已经会写 SQL 了,是不是 Data Agent 的问题也跟着解决了?
这个问题问得很自然。过去一年,大家看多了同一类演示:模型调用工具,工具返回结果,界面上出现一段思考过程。看起来都是 Agentic。于是很容易得出下一步推论——既然循环一样,产品难度也应该差不多;既然 Code Agent 已经能写 SQL,Data Agent 剩下的只是把仓库连上。
从循环上看,这话是成立的。模型想一步、调一次工具、读回结果、再决定下一步,这个骨架三种产品都在用。
但从产品上看,三种 Agent 面对的问题、核心难点、优化目标,并不在同一处。能力可以重叠,重心不能混。把它们当成同一个产品来做,最后通常是:SQL 会写了,数字却不敢用。
我个人认为,这是这一轮 Agent 产品里最容易被看错的一件事。看演示的人,看到的是同一套 Agentic 循环;做产品的人,每天卡住的地方完全不同。推论省事,但会把真正难的部分藏起来。文章会长一点,请你耐心。下面我一段一段往下讲。
二、三种 Agent 看起来都在调工具,产业上卡住的地方完全不同
先把交付物说清楚。三种工作 Agent 看起来都在调工具,也都会写一点 SQL。真正把它们分开的,是交付什么、卡在哪里、怎样才算做完。
Code Agent 交付的是能工作的代码。它要读懂仓库,改对代码,再靠编译、测试、运行确认这件事做完了。程序能通过检查,并交出可运行结果,这件事就算往前走了一步。业务口径通常不是它的第一问题。把 Word、Excel、浏览器、内部系统串成一条跨软件流程,通常也不是。
通用办公 Agent 交付的是一件跨软件真正办完的事。它的难点在生态和连接:把已有软件接上,让流程穿过不同系统,最后真的跑通。某一个 Word 工具、某一个 Excel 工具、某一个浏览器工具做得再好,都不等于整条跨系统流程已经完成。单点好用,和整件事做完,中间还隔着权限、格式、通知、回写,以及系统之间那些并不友好的缝。办公场景里,失败往往不是模型不会写一段文字,而是流程在第二个系统门口停住了:登录态过了、字段对不上、附件没带上、写回被拒绝。一个工具做得再好,也撑不起整条跨系统流程。
Data Agent 交付的是一个数字,以及这个数字为什么可以信。它也经常写 SQL,也经常调工具。可它卡住的地方,很少是“会不会写 SELECT”。没有编译器和单元测试来判断“这是不是你要的收入”。写 SQL 只是一步。
三者当然有重叠。Code Agent 会写一点 SQL,办公 Agent 也会碰数据,Data Agent 也会改脚本、出报告。重叠存在,并不意味着产品难度可以互相替代。
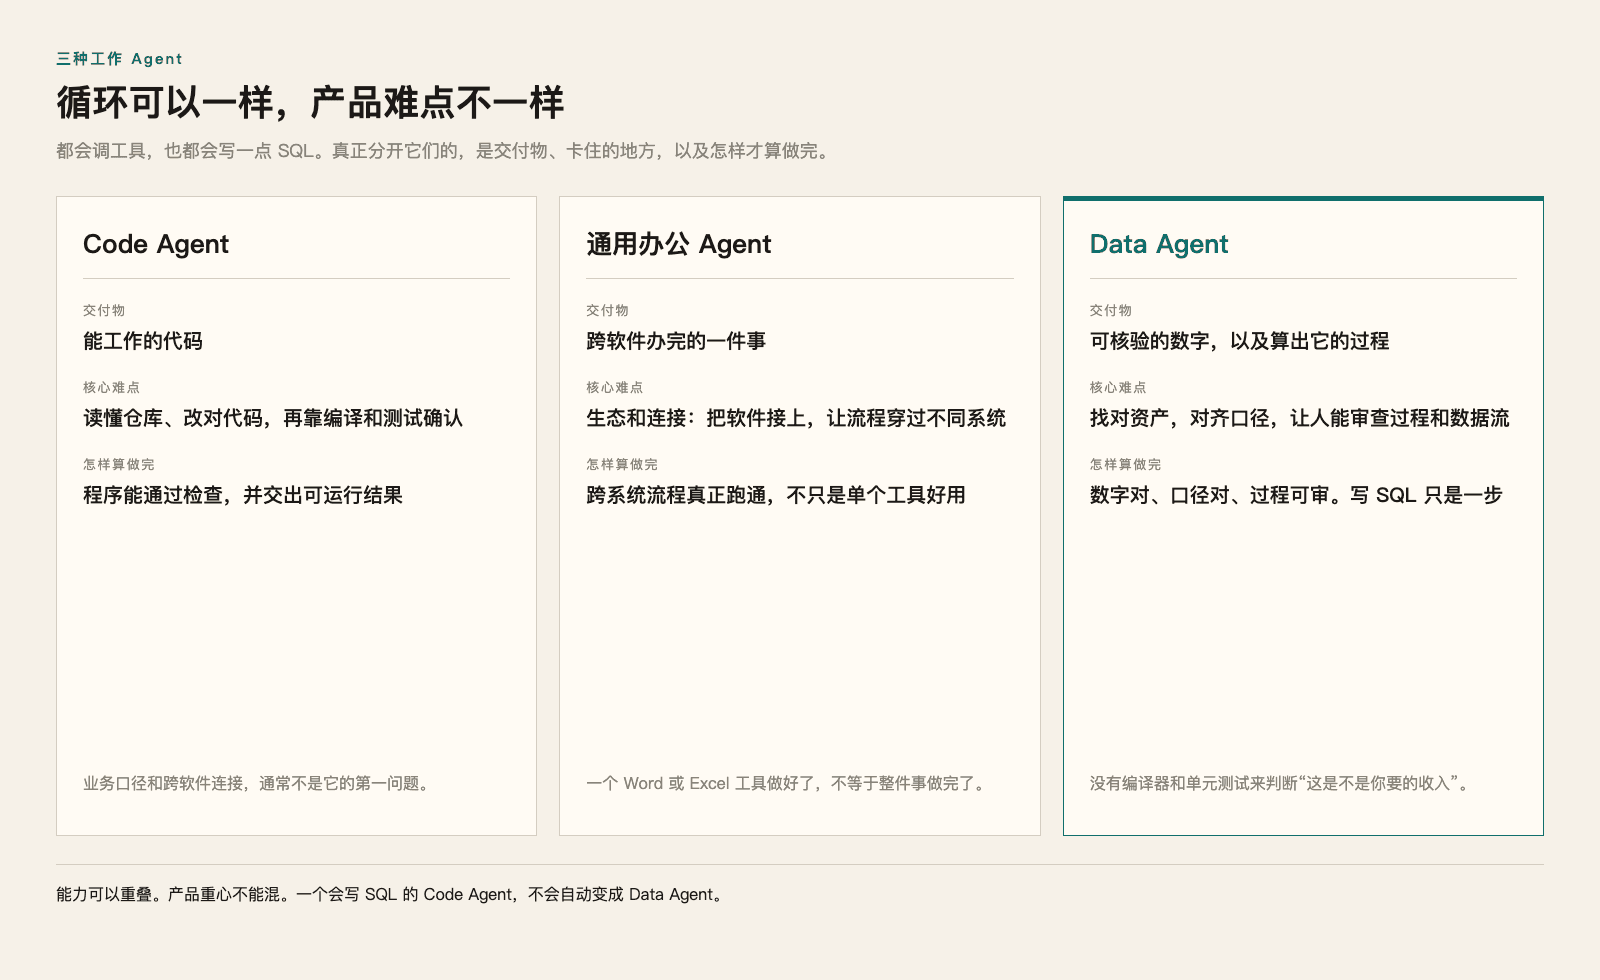
图 1:Code Agent、通用办公 Agent、Data Agent 都会调工具。真正分开它们的,是交付物、卡住的地方,以及怎样才算做完。
我们做一个简单的对比。Code Agent 的完成标准,大体上可以交给编译、测试、运行。办公 Agent 的完成标准,是跨系统流程真的跑通了,而不是某一个软件工具单独好用。Data Agent 的完成标准,是数字对、口径对、过程可审。三件事都叫 Agent,产业上卡住的地方完全不同。
这也是为什么我会把它们分开讲。写代码的人,关心仓库、改动和能不能跑。做办公自动化的人,关心软件有没有接上、流程有没有在第二个系统门口停住。做数据分析的人,关心这张表是不是收入、这个数字能不能拿去开会。三拨人都可以说自己在做 Agent,但他们要过的坎,不是同一道。
我得出一个很直接的结论:循环可以一样,产品难点不一样。一个会写 SQL 的 Code Agent,不会自动变成 Data Agent。
三、Data Agent 真正难的三件事
我们内部把 Data Agent 的三件难事叫做:资产搜索、口径对齐、结果可验证。对外讲的时候,幻灯片上写过更硬的三张卡片:百万级资产搜索失效、Source of Truth 难判断、没有确定性判题器。说法不同,指向同一件事。
先说第一件。
第一件,是在成百上千张表和文件里,找到真正相关的数据资产。漏掉一张表,或者看错一个字段,答案就会错。用户已经把几百张、甚至 1400 张以上的仓库连进来提问,治理往往还没做完。表名不友好,字段像暗号,同一个“收入”可能叫 ARR、确认收入、净收入,也可能藏在一张名字完全不像收入的事实表里。这时候第一能力不是生成 SQL,而是找到真正相关的数据资产。我们做过一次获客分析,从 8 张原始表走到约 19.9 万目标用户;那次真正难的,也是先找对那 8 张表,而不是最后那几句聚合。
什么意思呢?意思是仓库规模本身并不是成绩单。1400 张以上,只是说明已经有用户把这个量级的仓库连进来了。连进来之后,真正难的是:在这成百上千张表里,哪几张才跟这次问题有关。SQL 写得再顺,找错表,后面全是空转。
再说第二件。
第二件,是理解用户真正要的业务口径、Source of Truth 和定义。AI 要把用户心里那套意思对上,非常难。库里能查到的,是字段和行。公司真正认账的那一版,常常写在人的习惯、历史报表和口头约定里。字段类型里没有“这才是财务认的收入”这一栏。模型看到的是能查的列,人要的是这家公司怎么认账。
第三件,是让人方便核验一个重要数字到底对不对。Code Agent 算不算做完,常常可以看测试、编译、运行。Data Agent 算出来的数字准不准,取决于前两件有没有做成。即便前两件看起来做成了,重要数字仍然需要人去看过程和数据流。
这三件可以分开写,但它们绑在一起。漏资产、错口径,后面的 SQL 再漂亮也救不回来;过程不可审,数字就算对了也进不了决策。
我把这三件难事写成过一条公开帖子。
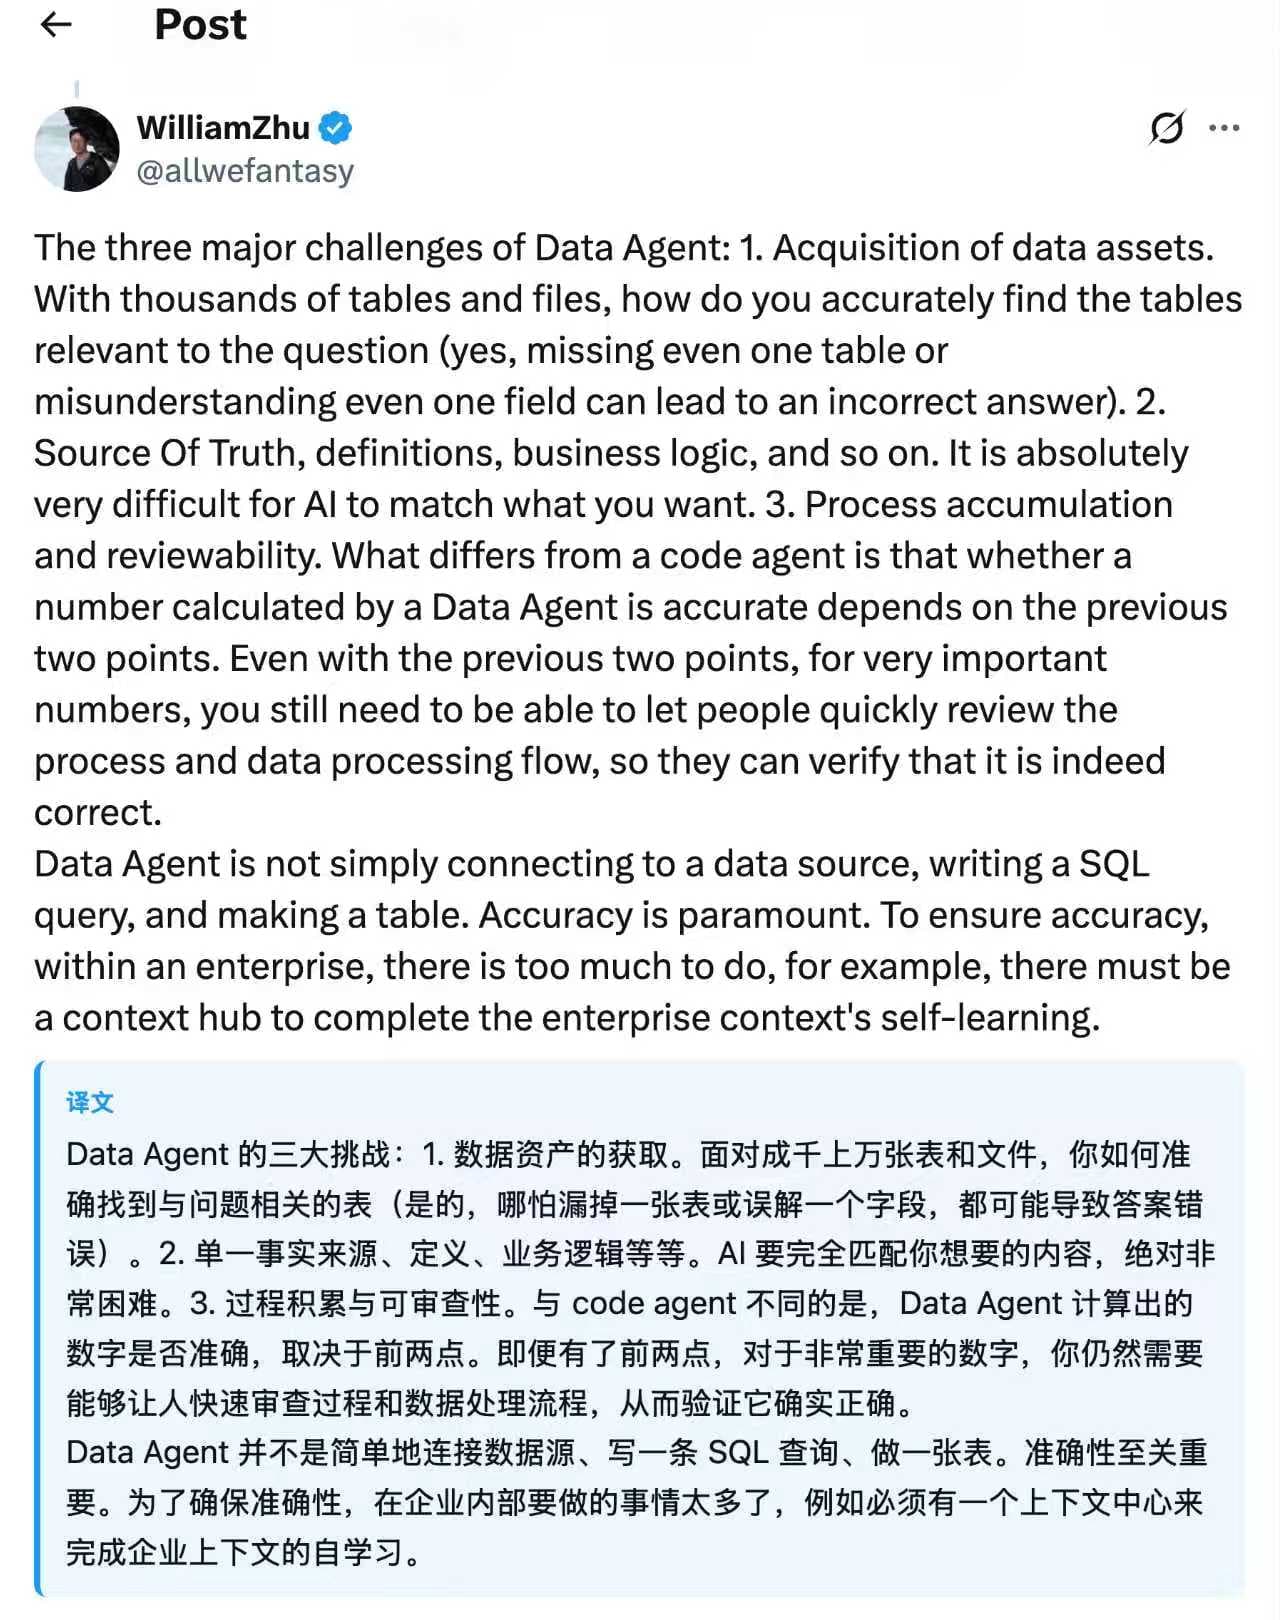
图 2:这是当时对 Data Agent 三件难事的公开表述。找到资产、对齐口径、核验过程,准确性至关重要,企业需要 Context Hub 完成上下文的自学习。
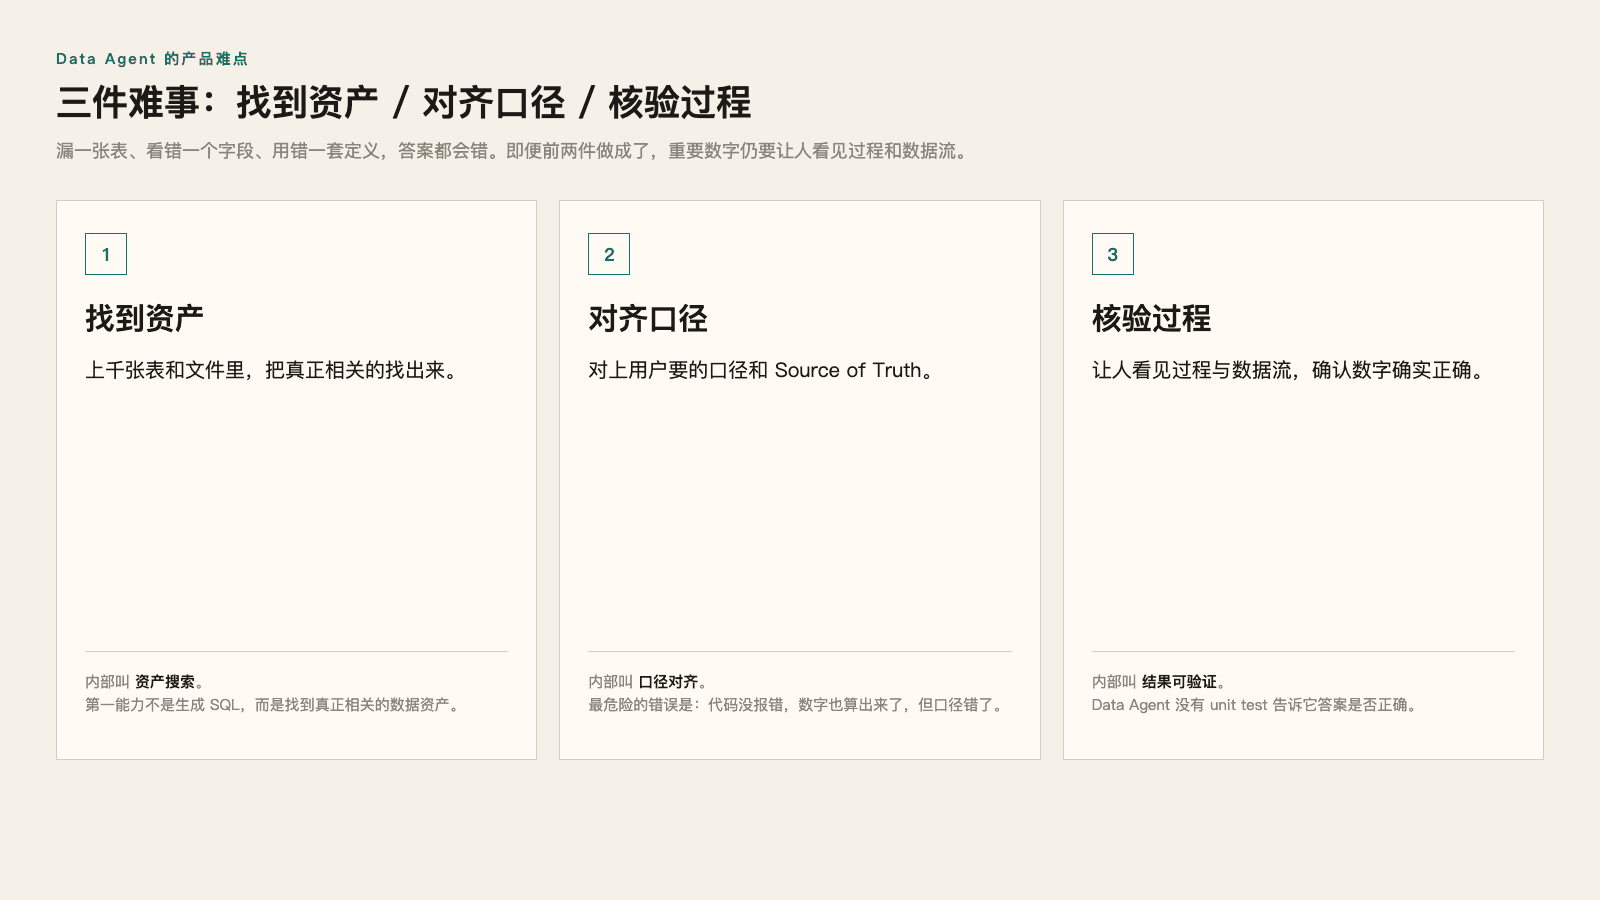
图 3:三件难事可以分开写,但它们绑在一起。漏资产、错口径,后面的 SQL 再漂亮也救不回来;过程不可审,数字就算对了也进不了决策。
把这三件放在一起看,会写 SQL 只覆盖了很小一块。资产没找对,SQL 写给了错误的表。口径没对上,SQL 算出了一个能跑、但不能用的数。过程摊不开,算出对了也进不了要为数字负责的场景。三件事里,生成 SQL 最多只是后面那一小步。
所以,会写 SQL,远不等于做好了 Data Agent。Data Agent 也不是连上数据源、写一条查询、做出一张表。准确性才是第一位的。为了把准确性做成可积累的东西,企业内部要做的事很多,其中必须有一个 Context Hub,用来完成企业上下文的自学习。这件事后面还要展开,这里先把判断放在这里。
四、数字能算出来,并不等于口径是对的
Code Agent 改完代码,编译器会报错,测试会红,运行时会崩。这些东西并不完美,但它们是存在的。程序过不了检查,至少还有人知道这次没做成。
Data Agent 没有 unit test 告诉它答案是否正确。最危险的错误是:代码没报错,数字也算出来了,但口径错了。查询执行了,表格画出来了,聊天框里出现一个干净的整数。没有报错,也就没有警报。
我们做一个简单的对比。
“一季度收入”四个字,销售按签约算,财务按到账算,两边都能在库里找到看起来很像样的字段。模型选了其中一张表,写出能跑的 SQL,返回一个整数。界面上它像正确答案。业务上它可能答非所问。
我们见过同一句英文问法:Let’s calculate the revenue in the first quarter. 销售口径可以给出 410 万,财务口径是另一套数。两个数字都能从真实表里算出来,它们回答的却不是同一个问题。如果系统只交出其中一个,还把它当成“收入”,后面所有讨论都会在错的定义上滑行。
什么意思呢?意思是 410 万这个数字本身未必算错。它可能就是销售那一版。问题在于,提问的人要的到底是哪一版,系统有没有把它讲清楚。Source of Truth 不写在字段类型里。它写在这家公司怎么认账、哪个团队用哪个定义、这次提问的人到底要哪一版。匹配用户真正想要的东西,对 AI 来说非常难,对产品来说却不能绕开。
如果系统只会生成 SQL,它会把这种错误包装成一次成功的工具调用。会写 SQL 的系统,恰恰最容易把这个错误藏起来。我得出一个很直接的判断:数字能算出来,并不等于口径是对的。
五、没有判题器的行业,只能把过程摊开给人看
即便资产找对了,口径也对上了,重要数字仍然需要人能快速审查过程和数据处理流程。
聊天框里的最终答案不够。人要能看见用了哪些表,中间生成了哪些结果,数字从哪一步算出来,依赖怎么走。Code Agent 至少还有测试和运行结果可以当判题器。Data Agent 没有确定性判题器。没有判题器,就只能把过程摊开,让人自己追回去。
产品上,这表现为可打开的步骤、可点开的 SQL、可查看的中间表,以及一张能拖、能放大的数据血缘。我们在跨库分析任务里会留下这样的图:节点是表,边是依赖,人可以沿着数据流把一个结论追回去。
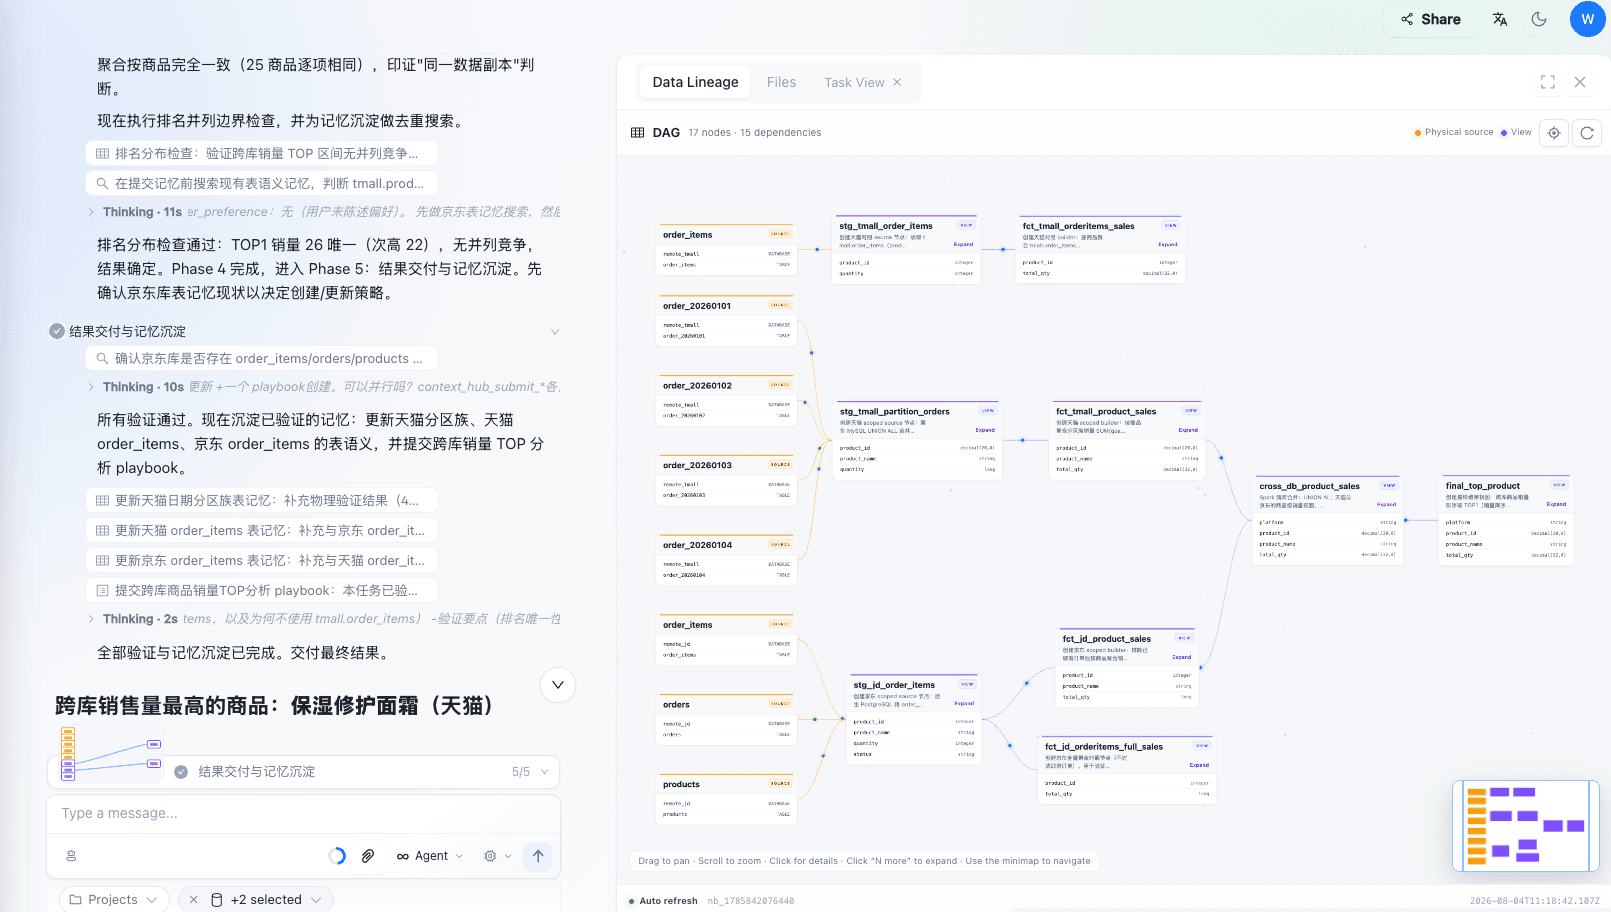
图 4:跨库分析任务里留下的数据血缘。步骤、中间表和依赖可以沿着图回看,而不是只留下聊天框里的一句结论。
没有这层可见性,Data Agent 就算偶尔算对,也很难进入真正要为数字负责的场景。企业不会只因为模型说“我很确定”,就把一个收入数字写进决策。财务、运营、风控要的不是一个聊天气泡,而是能把数字从结论追回表、从表追回过滤条件、从过滤条件追回口径版本的那条路径。追不回去的数字,用一次就要再吵一次。
这也是 Data Agent 和 Code Agent 的一个分界。代码有测试和运行结果当判题器;Data Agent 没有确定性判题器。可靠性只能来自过程可审、口径可对、中间结果可查。没有判题器的行业,只能把过程摊开给人看。
六、Context 不能每次从零开始
三件难事加在一起,会逼出一个结论:Data Agent 必须有自学习系统。使用过程里产生的口径、案例、表含义和偏好,要能自动积累成企业 Context。否则它会一直不好用。每一次新会话都从零摸表、从零猜“收入”是什么,用户会不断地教同一个定义。产品用得再久,也还是第一次见面的那个状态。
这条更新路径我们写得很死:
发现口径不对 → 人给出修正 → Agent 反思并生成知识更新 → 人工审核 → 进入 Context Hub → 后续任务召回。
知识不能由 AI 悄悄改写。Agent 可以提议更新,人在 Review Center 批准或拒绝。通过的东西进入 Context Hub,对象就四类:Table Data、Cases、Metrics、User Preferences。后续任务再召回。未通过的更新,不能成为公司事实。
这四类对象,分别管的是不同的东西。Table Data 是表和字段的业务含义。Cases 是已经做过的问题和路径。Metrics 是指标名称、定义和计算口径。User Preferences 是结果形式和表达上的偏好。人在 Review Center 看到的,也就是这四类待审核的更新。Agent 可以起草,但不能自己生效。
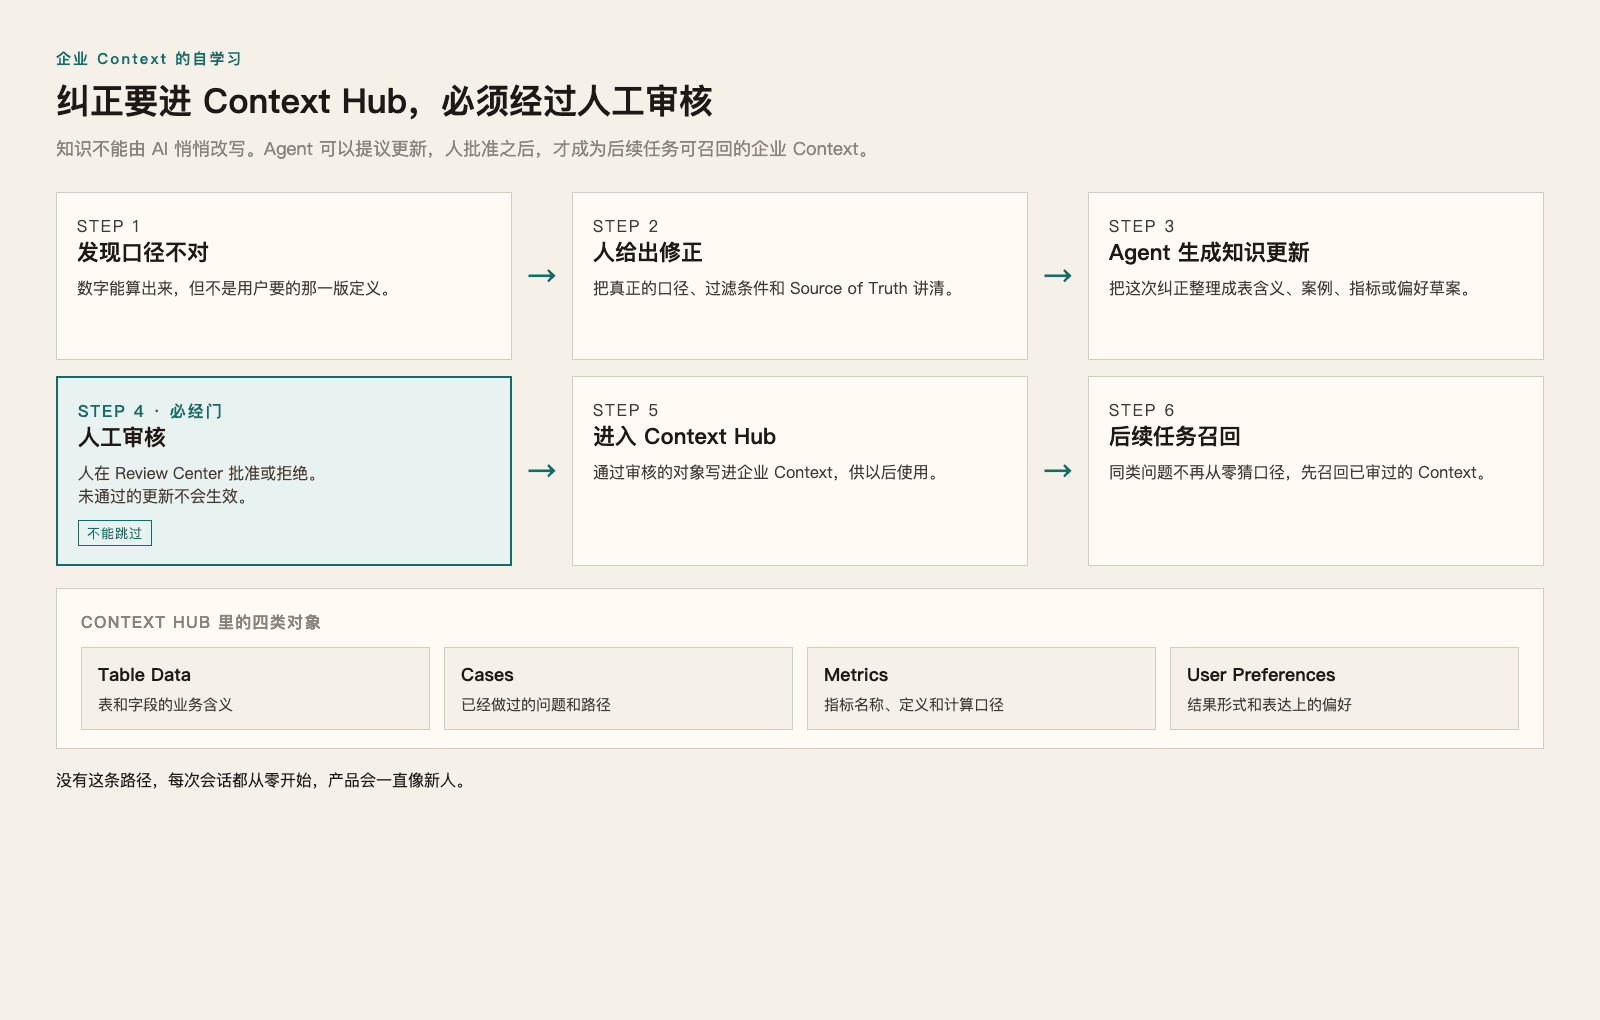
图 5:纠正要进 Context Hub,必须经过人工审核。未通过的更新,不能成为公司事实。
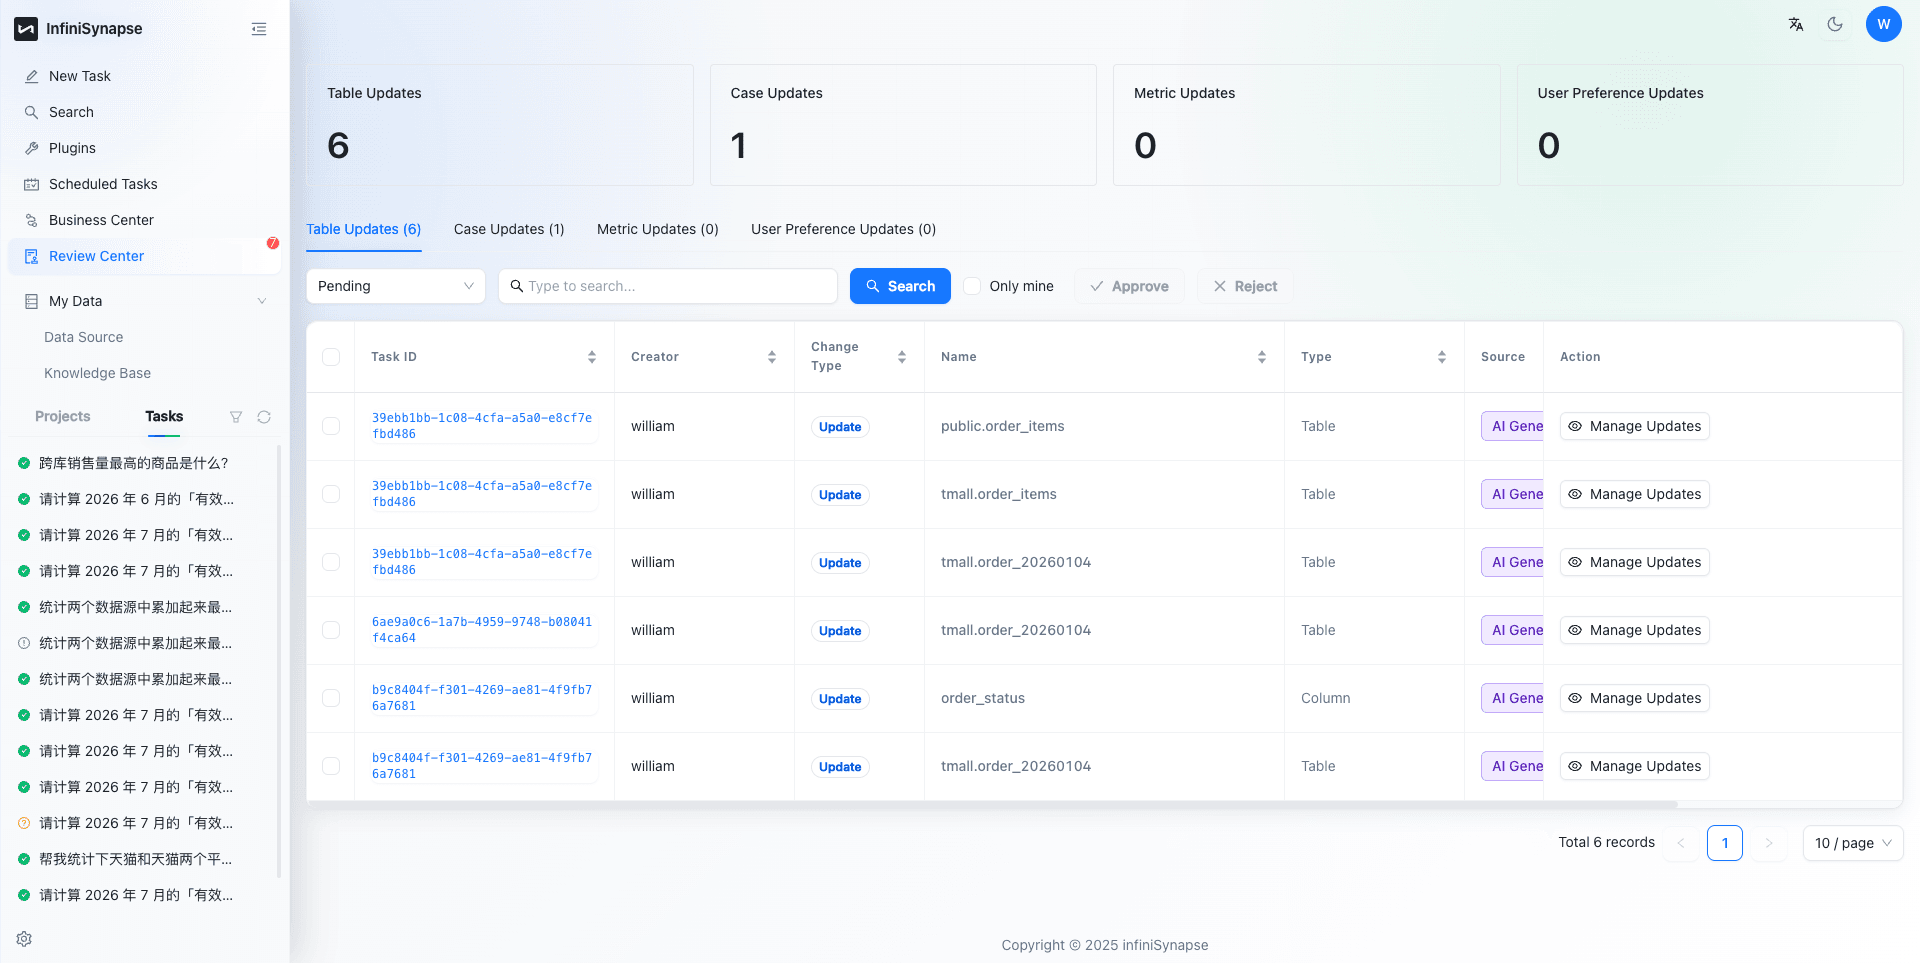
图 6:Review Center 把待审核的表、案例、指标和偏好更新集中起来,由人批准或拒绝。AI 不能悄悄改写企业 Context。
老规矩,我们先把数字摆出来。有一个公开做过的对照。同一句问法:Let’s calculate the revenue in the first quarter.
| 没有可用 Context | Context 进入之后 | |
|---|---|---|
| 时间 | 8 分 23 秒 | 2 分 48 秒 |
| 步骤 | 12 步 | 15 步 |
| 人纠正 | 1 次 | 0 次 |
| 交出的结果 | 一个数字 410 万 | 销售和财务两套口径并列,回款率 48.78% |
请你重点看步骤那一行。后面那一次并没有变少,甚至从 12 步变成了 15 步。变的是时间,从 8 分 23 秒到 2 分 48 秒;变的是纠正次数,从 1 次到 0 次;更重要的是,数字从“一个看起来像样的整数”,变成了两套定义并排,外加一笔能对上的回款。
什么意思呢?意思是省下来的摸底时间,用到了交叉核对上。没有 Context 的那一次,系统最后给出 410 万,人还纠正了一次。Context 进来之后,同一句问法不再只交一个整数,而是把销售和财务两套口径摊开,并且算出回款率 48.78%。步骤多了三步,时间少了一半还多,纠正从有到无。
企业要的就是这个 Context Hub:让企业上下文能够自学习,并且每一次学习都过人手。没有它,产品不会因为多用几天就变得更容易。它只会反复回到第一次见面的那个状态。
七、探索不能把数据库打满
产品层的三件难事之外,引擎层还有另一组问题。第一件是:AI 怎样高效探索,同时不给数据库太大压力。
Agent 的本能是多看。列表、抽样、聚合、再换一个维度。如果每一步都对源库做全表扫描,探索本身就会变成事故。仓库越大,这个问题来得越快。连进来的表是几百张还是 1400 张以上,都改变不了这件事:探索必须便宜,重计算必须晚出现。
我们的做法是把便宜的动作放前面。先 !show、先看表结构、先 LIMIT 抽样,再做重的聚合。DirectQuery 把计算留在源端,数据不动,计算下推。复杂问题可以分步写成短片段,Scope 再把这些片段编译成一条下推 SQL,中间结果不必先拉回引擎。
还有一个更省的动作:Explain-before-execute。DirectQueryExplain 只看编译出来的 SQL,不碰源库的行。人或者 Agent 可以先读计划,再决定要不要跑。
这里有一个容易说错的地方。DataSummary 这类画像会真正去读数据,不能把它说成“不碰源库”。省源库的,是元数据查询、限制行数的抽样,以及只编译不执行的 Explain。
嗯,说一下我的想法。探索如果把数据库打满,后面的口径和核验都还没开始,系统就已经先把仓库压垮了。引擎层第一件事,是让 Agent 多看的本能,不要变成对源库的全表扫描。
八、SQL 把窗口撑爆之后,Agent 自己也看不全
第二个引擎问题:复杂业务会写出大量 SQL。怎么让 SQL 信息密度高、执行有效,同时不把 LLM 的上下文窗口撑爆?怎么让 SQL 适合 Agent 使用,让模型把注意力留在业务上,而不是留在写 SQL 上?
问题再复杂一些,Agent 的 SQL 不能膨胀到几万行,远超窗口。Agent 如果看不见整段 SQL,就无法判断这段 SQL 对不对。窗口被撑满之后,模型看到的是残片。残片上无法做代码审查。
InfiniSQL 把中间结果落成具名会话表,状态按 owner 放在服务端。后面的调用只需要表名,不必把上一张表的数据或上一句长 SQL 再塞回模型。上下文里留下的是名字和结构摘要,数据本身不过模型。换一次模型、断一次连接,只要还是同一个 owner,前面那些表还在。分析现场不再跟某一次对话窗口绑死。
模板压缩是其中一个已经记过的例子,不是普遍定律。老规矩,我们先把数字摆出来。GA360 按日分表那次,手写枚举是 1,713 行、79,384 字节、大约 2 万 token;改成模板后是 52 行、1,337 字节、大约 370 token。那是测试环境里的一次复刻,用来说明:压缩发生在引擎侧,比生成完再摘要更干净。
| 手写枚举 | 改成模板后 | |
|---|---|---|
| 行数 | 1,713 行 | 52 行 |
| 字节 | 79,384 字节 | 1,337 字节 |
| token | 大约 2 万 | 大约 370 |
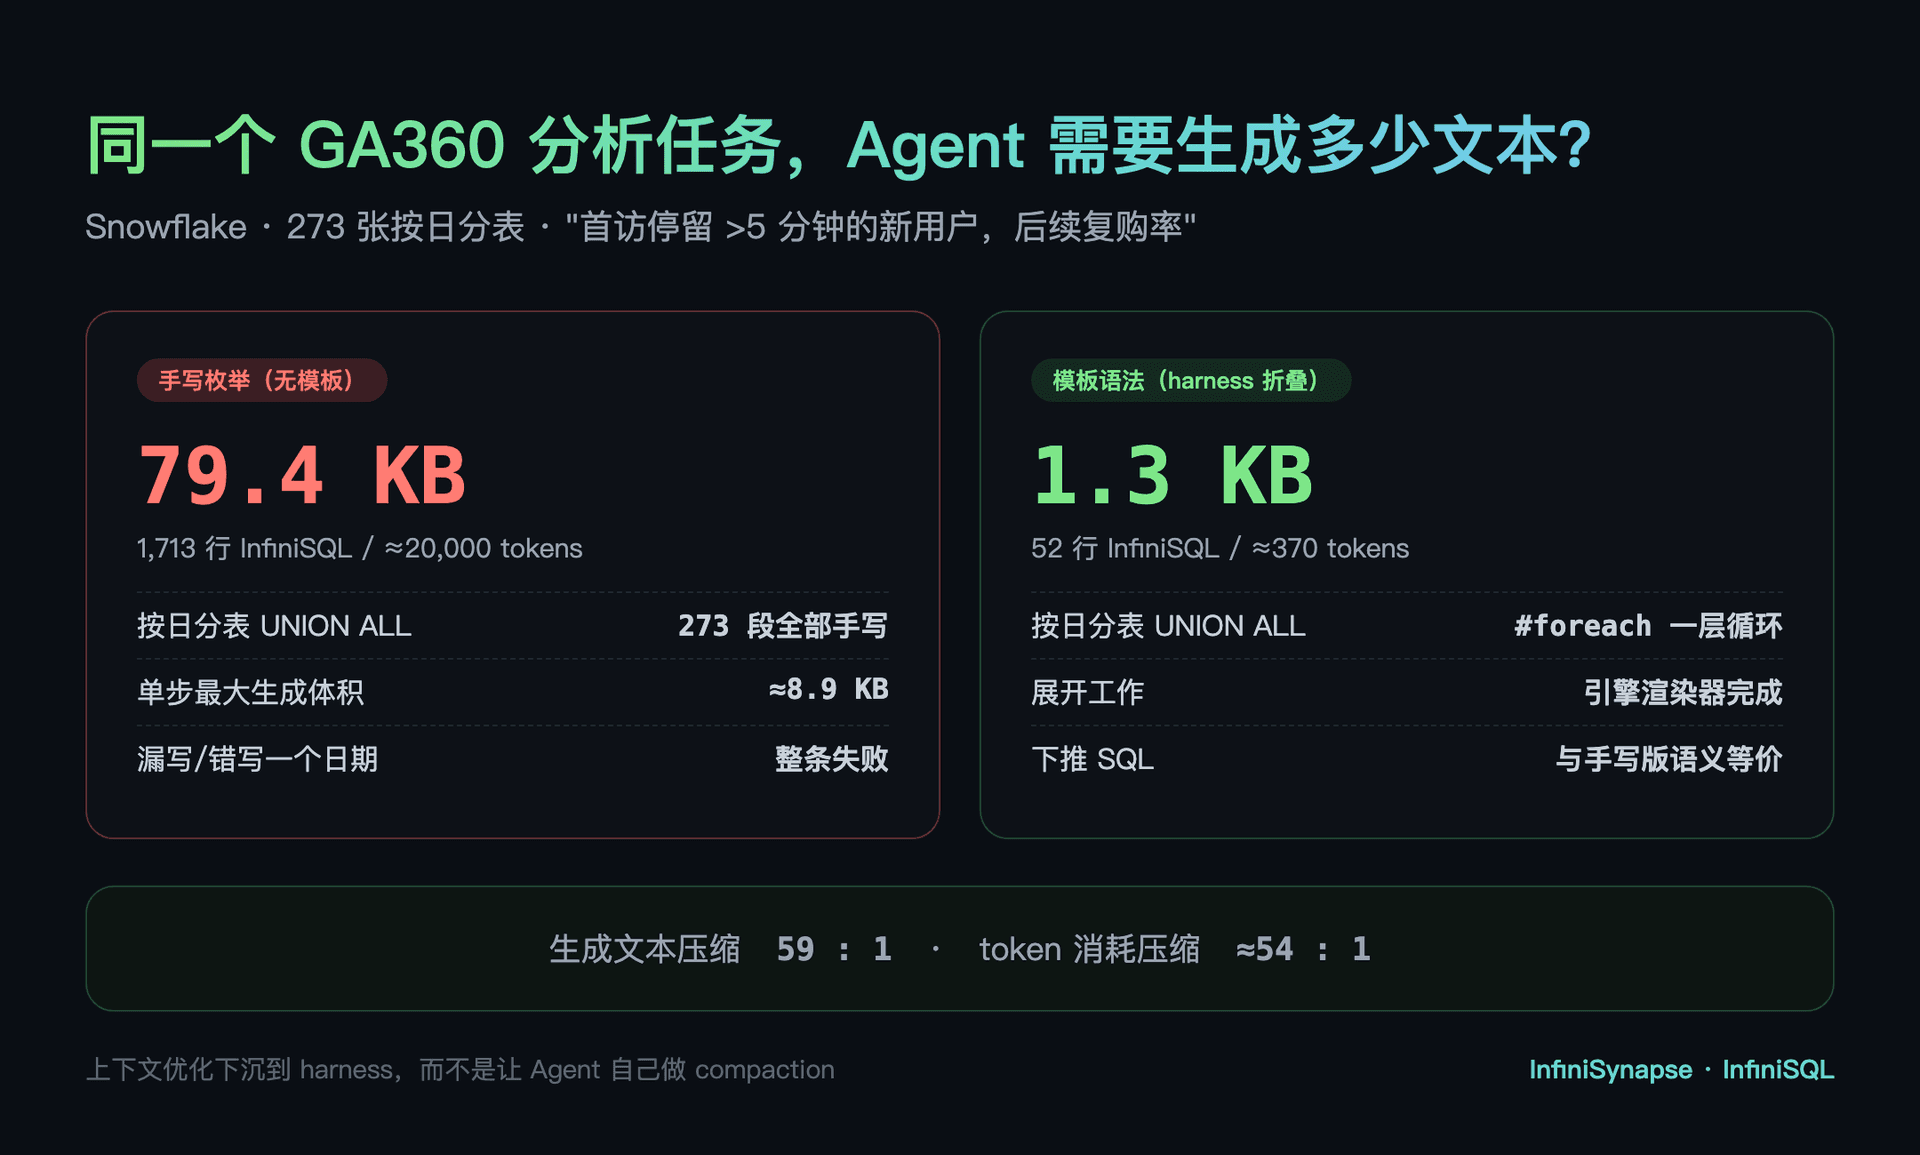
图 7:GA360 按日分表的一次测试环境复刻:1,713 行收到 52 行。这是该任务的实测,不是 InfiniSQL 的普遍压缩比。
请你重点看这组数字。1,713 行收到 52 行,大约 2 万 token 收到大约 370 token。这是该任务的实测,不是 InfiniSQL 的普遍压缩比。我不能把它写成一条到处适用的定律。但它说明了一件事:如果把展开工作留在引擎里做,模型窗口里就不必先堆几千行再自己摘要。
每一步工具调用,也不该要求写几百行、几千行 SQL。每一步要写的 SQL 不能太重。这需要引擎,不是只把 prompt 写得更聪明。
SQL 把窗口撑爆之后,Agent 自己也看不全。看不全,就谈不上判断对错。
九、InfiniSQL 要做的,是让模型把力气留在业务上
InfiniSQL 的顶层表面很小:load、select ... as、save、train、register 这些,大约十个动词。每一步是一句短语句,落成一张有名字的表。Agent 下一步该问的是业务问题:这张表是不是收入、要不要并上到账、过滤条件对不对。它不该在窗口里写一部 2000 行的 SQL 长篇。
短,不只是为了好看。短了之后,人才能读完这一步;Agent 才能把这一步和上一张表对上;出错时才知道该改哪一句,而不是在几千行里找一个漏写的日期。引擎把展开、下推、命名这些事接走,模型才有机会把注意力留在口径上。
这也是为什么 Data Agent 不能靠 LLM 加一个 SQL 客户端做完,而必须重做运行时、语言、知识和执行引擎。语言负责把每一步变短,运行时负责把状态留在服务端,知识负责把口径留下来给人审,执行引擎负责下推和 Explain。
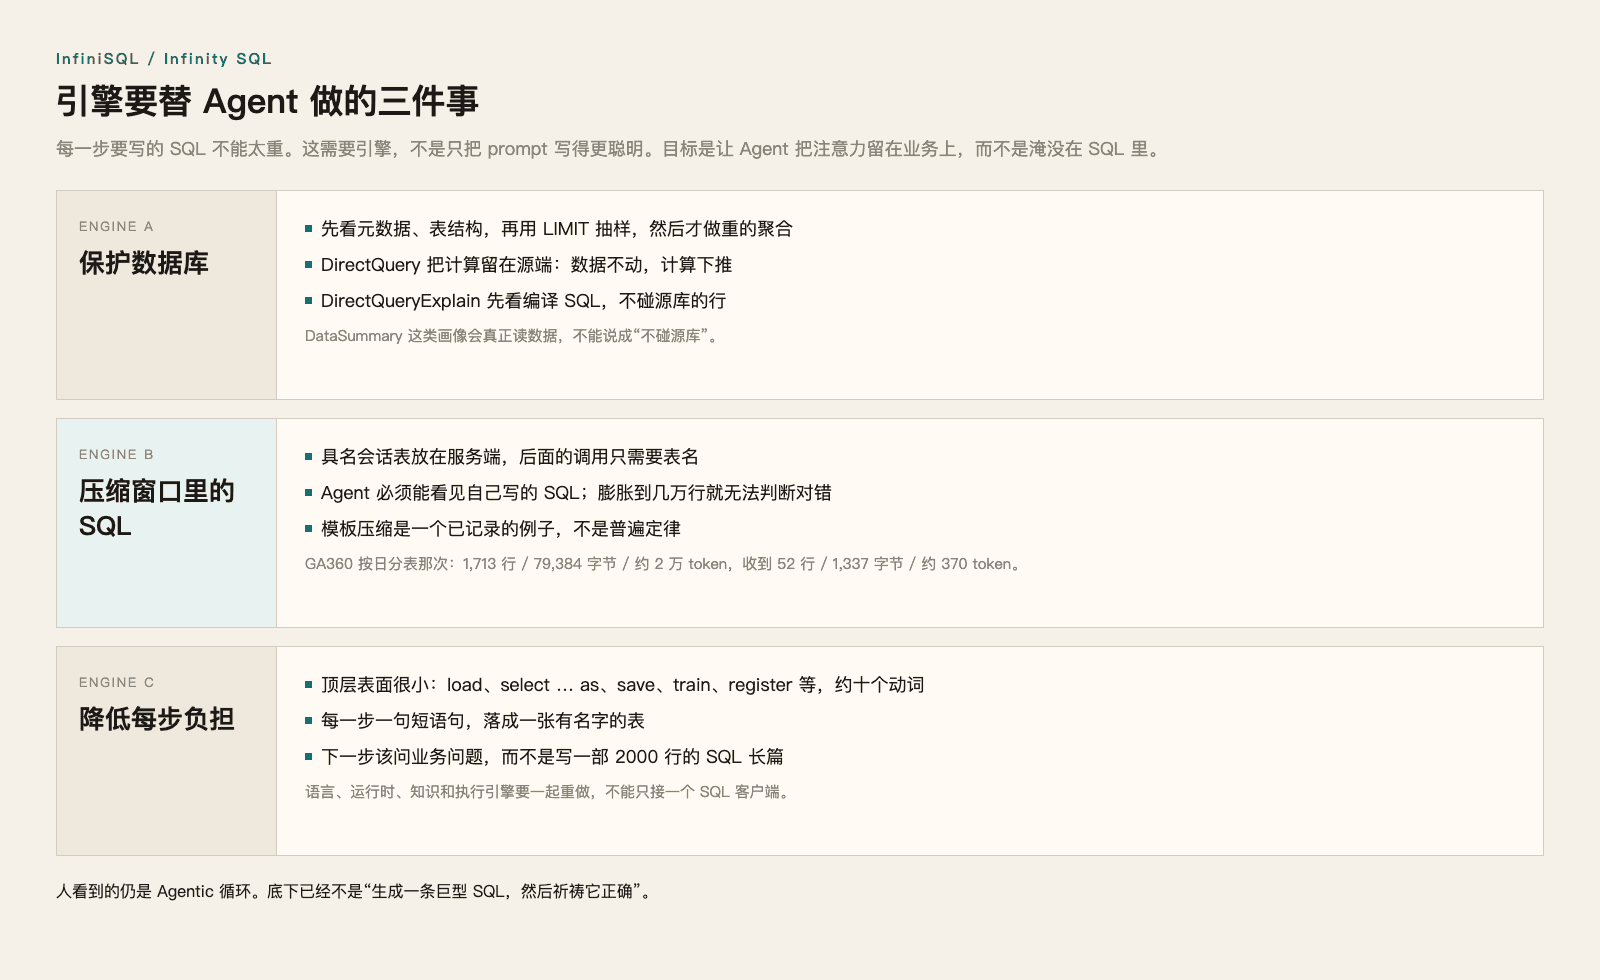
图 8:引擎层要替 Agent 做的三件事。人看到的仍是 Agentic 循环;底下已经不是生成一条巨型 SQL,再等它碰巧正确。
人看到的是:Agent 还在做 Agentic 循环。底下已经换了一套工作方式。每一步短,状态在服务端,编译结果可以先看,口径更新必须过人。模型仍然在调工具,只是工具不再逼它同时当 DBA、当指标管理员、再在窗口里写一部长 SQL。
InfiniSQL 要做的,是让模型把力气留在业务上,而不是淹没在 SQL 里。
十、收束:会写代码,不会自动变成 Data Agent
文章写到这里,已经不短了。我做一个简单的收尾。
同样的 Agentic 方法,产品难度并不一样。
一个会写 SQL 的 Code Agent,不会自动变成 Data Agent。一个接得上 Word 和浏览器的办公 Agent,也不会自动解决口径和核验。一个 Data Agent 如果不能积累 Context,用得越久也不会变得更容易。
我们做 InfiniSQL,是为了让 Agent 把注意力留在业务上,而不是淹没在 SQL 里。产品层那三件——资产搜索、口径对齐、结果可验证——加上引擎上那几件:探索要便宜、窗口不能被 SQL 撑爆、每一步不能写成一部长篇,才构成一个能被企业使用的 Data Agent。少任何一件,表面上都还是“大模型在调工具”。用起来就会知道,那不是同一个产品。
我个人认为,会写 SQL,远远谈不上做成了 Data Agent。这件事,要从产品难点上看,不能只从循环上看。Code Agent 会写 SQL 了,是一件好事,也只说明循环这一层已经通了。真正难的那些事,还在后面。