上一篇实测发出去之后,我们没停手:同一套苹果 10-K 语料、同一批 79 个样本,这次把判定器从两个扩到六个。除了上次对垒的官方 Jev 和生产在用的 DeepSeek Flash,又拉来了 DeepSeek Pro、向量检索,以及两个开源复现的 System One 模型——openjev 和 semif。
先把结论放在这——官方 Jev 以 92.2% 的准确率打平 Flash 并列第一;两个开源复现版分别只有 75.9% 和 79.7%,把判定阈值拧到最严也只追到 85% 左右。标题说的「完胜」,指的是同一份考卷上正版和复现版之间这 12 到 16 个点的差距。
新上桌的选手
先交代一下这次新增的面孔。
openjev 和 semif 是社区按 System One 思路复现的开源模型,分别基于 Qwen3.6-35B-A3B(NVFP4)和 Qwen3.5-4B(FP8),部署在我们自己的 LLM Gate 网关上,走和 TypeSafe 官方完全一致的 System One 契约——一次前向返回概率分布,输出 yes/no + 分数。为了接上它们,召回链路这轮新加了 custom provider:endpoint、model、API key 三个参数填上就能接入任何 System One 兼容端点,已经端到端实测跑通。
第三位新选手是向量检索:doubao embedding 算余弦相似度,文档按 10k 字符切块取最大值。它没有判定模型,本质是个对照组——用来回答「召回判定这件事,向量相似度到底能不能直接干」。
语料和样本跟上轮完全一样:Apple 10-K 年报 FY2016 到 FY2025,20 份文档,25 个按年份锚定的问题,79 个 (question, doc) 对,其中 52 个是「看着像但年份不对」的 hard negative。判定契约和阈值(5 分)两边对齐,openjev / semif / vector 是本轮真实 API 调用,Jev / Flash / Pro 复用上轮缓存。
结果总表
79 个样本跑完,六个判定器的核心数据:
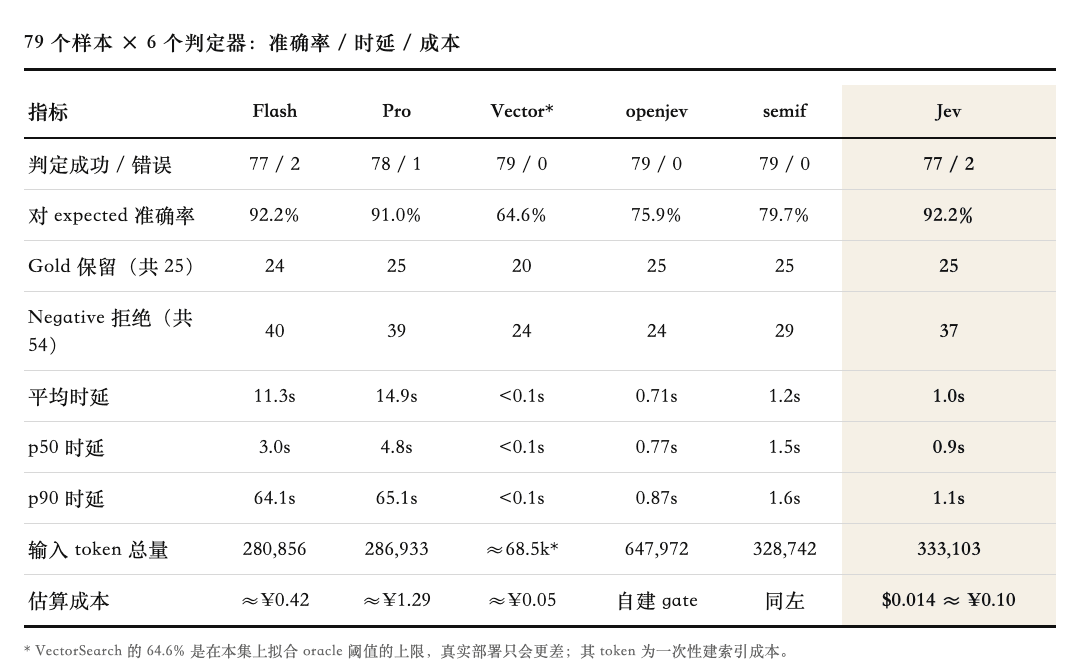
VectorSearch 没有天然的 yes/no 契约,表里 64.6% 是在本集上拟合出的 oracle 阈值下的上限——真实部署只会更差。它是六个判定器里唯一不能直接当过滤器的。
两个值得单独看一眼的数字:openjev 的平均时延 0.71s,比官方 Jev 的 1.0s 还快——复现版在速度上没有输;但准确率 75.9%,差了 16 个点。这是一场「跑得快但判不准」对「又快又准」的对比。
差在哪:概率校准
比准确率更能说明问题的是概率质量。看各判定器给出的 noul 概率,gold 组和 negative 组的均值:
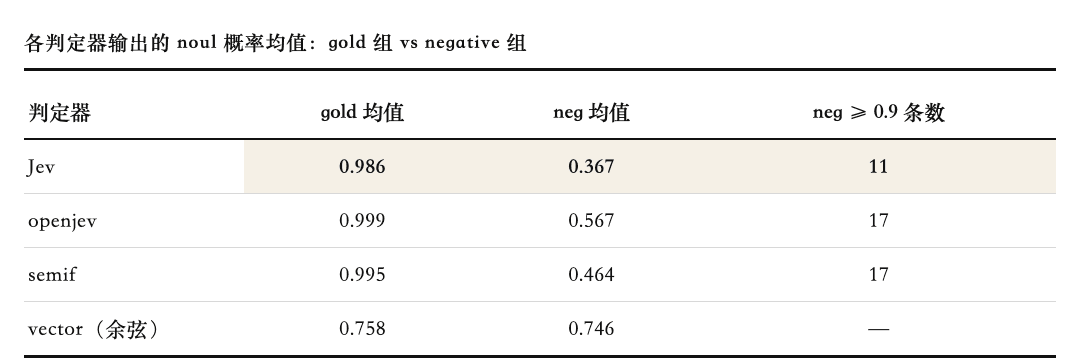
Jev 的概率是真校准:gold 顶到 0.99 附近,多数 hard negative 压到 0.5 以下。把判定阈值在 5 到 9 之间随便挪,准确率恒为 92.2%,gold 始终 25/25 全保留——对阈值选择完全不敏感,这在工程上意味着你不用调参。
openjev 的问题是整体偏高:negative 组均值 0.567,倾向放行。把阈值提到 8–9,准确率升到 84.8% 且 gold 仍全保留,但还是够不到 92%。semif 居中,阈值 7–8 时 82.3%——一个 4B 小模型做到这个程度可以接受,但同样偏宽。
向量检索则是另一种输法:gold 0.758 对 neg 0.746,区分度只有 0.012——相邻年份同章节的文档在向量空间里就是孪生。上一轮我们说「看着都对但年份不对」是召回最容易翻车的场景,这次算是实锤了:这种场景向量相似度天然无解,所以才需要判定模型。
判定一致率也佐证了差距:Jev 和 Flash 94.7%、和 Pro 96.1%,但和 openjev 只有 80.3%、和 semif 80.5%——开源复现版和正版在决策边界上明显不是同一个模型。
响应时间:快和稳是两回事
上一篇只报了平均时延,这轮补了专项。两个口径:79 样本全集的完整分布(4 并发采集,含排队竞争噪声),以及今天下午新跑的 10 样本串行基准——同一时刻只有一发请求在飞,逐条记录耗时。
全集分布里,三个 System One 判定器的 p99 都压在 3.3 秒以内;生成式 LLM 是另一个画风——Flash 和 Pro 的 p90 分别冲到 64.1s 和 65.1s,那是撞上 60 秒超时重试的样本。「均值尚可、尾部失控」这八个字,做实时召回过滤是绕不开的。
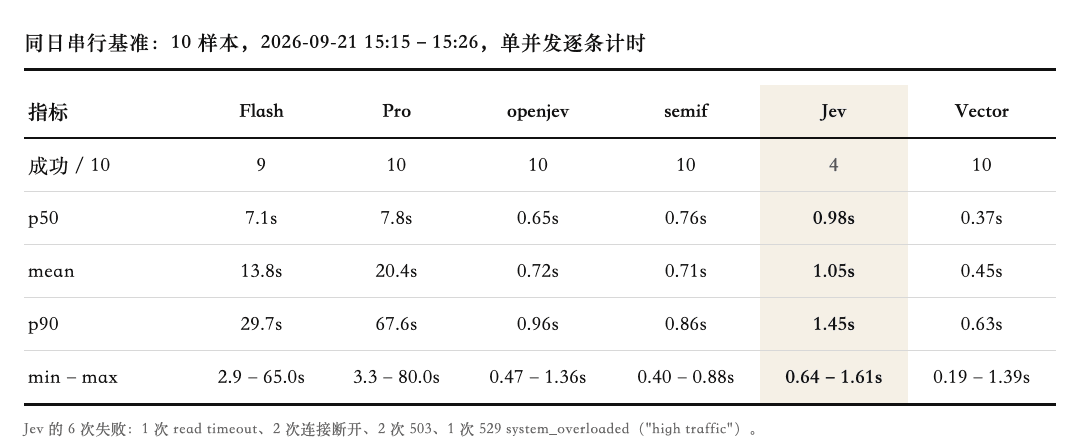
更值得说的是串行基准暴露的新情况:Jev 官方端点今天下午在抖。15:15 到 15:26 的窗口里 10 次调用只成功 4 次——1 次 read timeout、2 次连接被远端断开、2 次 503、1 次 529 system_overloaded,返回体里写着 "high traffic, please try again later"。成功的 4 次延迟 0.64–1.61s,和昨天的全集数据一致——快还是快,是可用性下来了。变慢的原因,我们猜多半是最近它的访问量有点大——529 的过载提示基本等于官方自己承认了这个解释,但到底是不是,只有 TypeSafe 知道。
对照之下,同一窗口 gate 上的 openjev 和 semif 二十次调用全部成功、全部小于 1.4s——自托管的开源复现版在可用性上反而更稳,只是判定质量差一截。这正好把它们的位置说清了:降级链第二级,不是主判定。
工程含义也跟着变了:rag_jev_on_error=fallback_llm 兜底从「建议配置」变成「实测必须」——生产接 Jev 不配兜底,就是在赌官方端点的在线率。
换算到每题召回耗时(本语料每题平均判 3.16 篇候选文档):串行判定 Jev ≈2.8s、openjev ≈2.1s、semif ≈2.4s、Flash ≈9.5s、Pro ≈15.3s;而「向量粗筛 + Jev 精判」的组合,每题约 0.4s 召回加只对 top-k 做 1 秒级判定,依然是延迟和质量的最优折中。
向量检索的尴尬
这轮顺带测了它的召回排名能力:每题 gold 文档的相似度排名,top-1 命中 16/25,top-3 命中 25/25。也就是说,向量适合当 top-k 粗筛——把候选从 N 个砍到 3 个,再交给 Jev 或 LLM 做相关性判定;不适合单独当过滤器。这和我们 hybrid-index(embedding + 向量库)的既有定位完全一致。但从我个人的角度来看,我觉得向量一直都处于一个非常尴尬的位置:本身效果差,效果难以提升,也不满足 Scaling law 这个范式,而且,它和大语言、自然语言并不是天然匹配的,需要先进行向量化。这也就意味着预处理、更新之类的都会成为难题,并且 context 一般也比较小,通常只有 4K、8K,信息密度非常低,所以我个人认为,能不用的话尽量不用。
怎么看这份数据
第一,「完胜」的证据链是完整的:同语料、同样本、同契约、同阈值,官方 Jev 92.2% 对 openjev 75.9% / semif 79.7%。开源复现版契约兼容、延迟漂亮(0.71s 全场最快档),但概率校准差一截,放行过多——System One 这条路线,模型权重的训练质量仍是壁垒,不是把接口对齐就能追平的。
第二,Jev 仍是主判定,但今天要加一条注脚:精度持平生产 Flash,gold 25/25 全保留,比 Flash 快 11 倍,单次判定约 $0.00018,概率校准好到阈值不敏感——判定质量没得说。但官方端点今天下午的可用性确实在抖。
当然,目前开源的这些没有经过二次后训练,只是在能力上做了兼容。我们也非常期待开源和闭源版本能够同步、双向发展。个人认为,Jev 其实带来了一个很大的范式变化。期待未来会有更多新的范式出现,而不仅仅是当前这种纯大语言模型的范式。