企业做数据治理,通常要把业务上的含义、数据库里的记录和分析时的计算方法对齐。同一个“销售额”,按签约、发货还是到账计算,会得到不同的结果。这里说的口径,就是一个指标按什么范围、时间和规则来计算。把口径确定下来,再让数据按这个规则参与计算,是业务负责人和数据团队长期共同承担的工作。
传统做法通常先建设数仓,把分散的业务数据加工、组织成方便分析的结构。这项建设需要依靠三拨人:研发、数仓与建模人员组织和加工底层数据,业务专家确定口径,分析师用 SQL 这种数据库查询语言取数、计算和分析。要了解一套数仓,往往也得找齐这三拨人,才知道表为什么这样设计、字段代表什么,以及一个业务问题该怎么回答。
引入 InfiniSynapse 之后,这些角色的定位发生了较大变化。业务人员可以直接取数,分析师更多负责让系统学会业务、审核结果和沉淀经验,业务专家在日常使用中把知识留下来。原先集中在数仓建设上的工作,则更多转向保证系统稳定。理解这套变化,可以从每个人一天的工作看起。
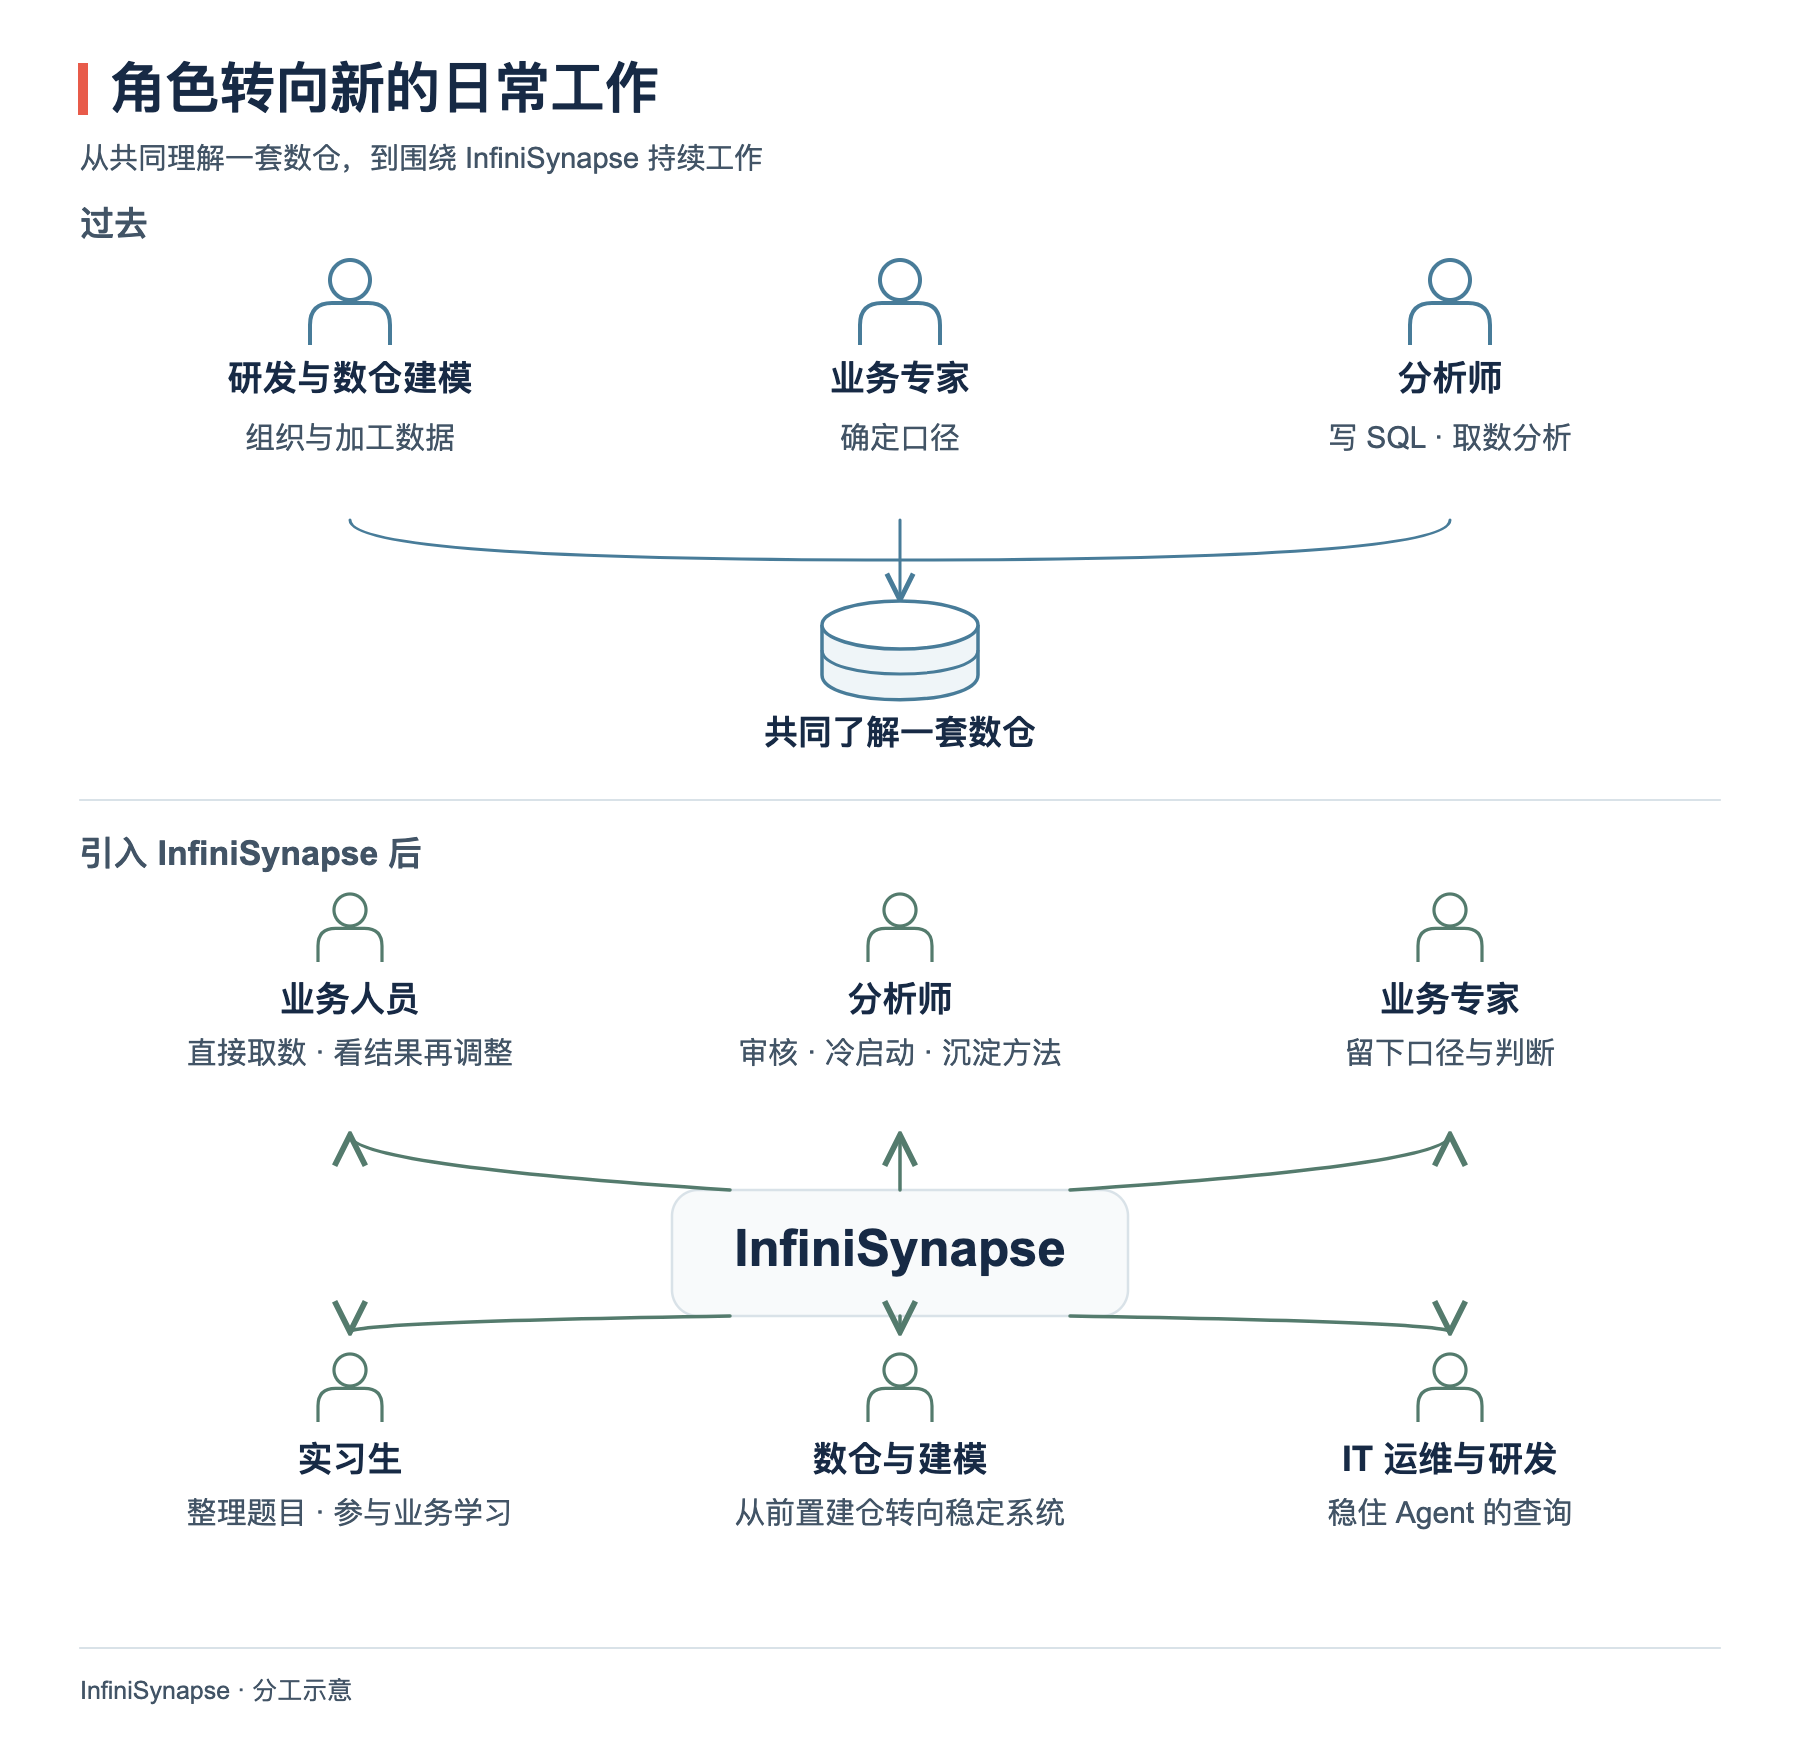
角色分工示意:上方为过去共同理解数仓的三组人员,下方为围绕 InfiniSynapse 工作的六类角色。
业务人员:看到结果,再把问题问清楚
过去,业务人员想了解销售变化,通常要先向分析师说明需求,等待对方找表、写查询、核对结果。如果拿到数据后发现还想看另一种分类,或者原来的统计范围有问题,就要再走一轮沟通。
困难在于,业务人员一开始往往说不清自己究竟需要什么。他可能先想知道“这个月销售怎么样”,看到结果以后,才意识到要区分区域、渠道,或者排除已经取消的订单。需求是在看数据的过程中逐步形成的。要求他在第一次提问时就写清全部条件,很容易把分析停在等待和解释上。
有了 InfiniSynapse,业务人员可以直接取数,不再依赖分析师代为完成每一次查询,而且可以马上看到结果。先看本月销售,再看其中某个区域,发现异常后继续追问;如果统计条件不合适,就当场调整。少了一次次排队交接,等待时间会大幅缩短,业务人员也更容易沿着结果把问题问深。
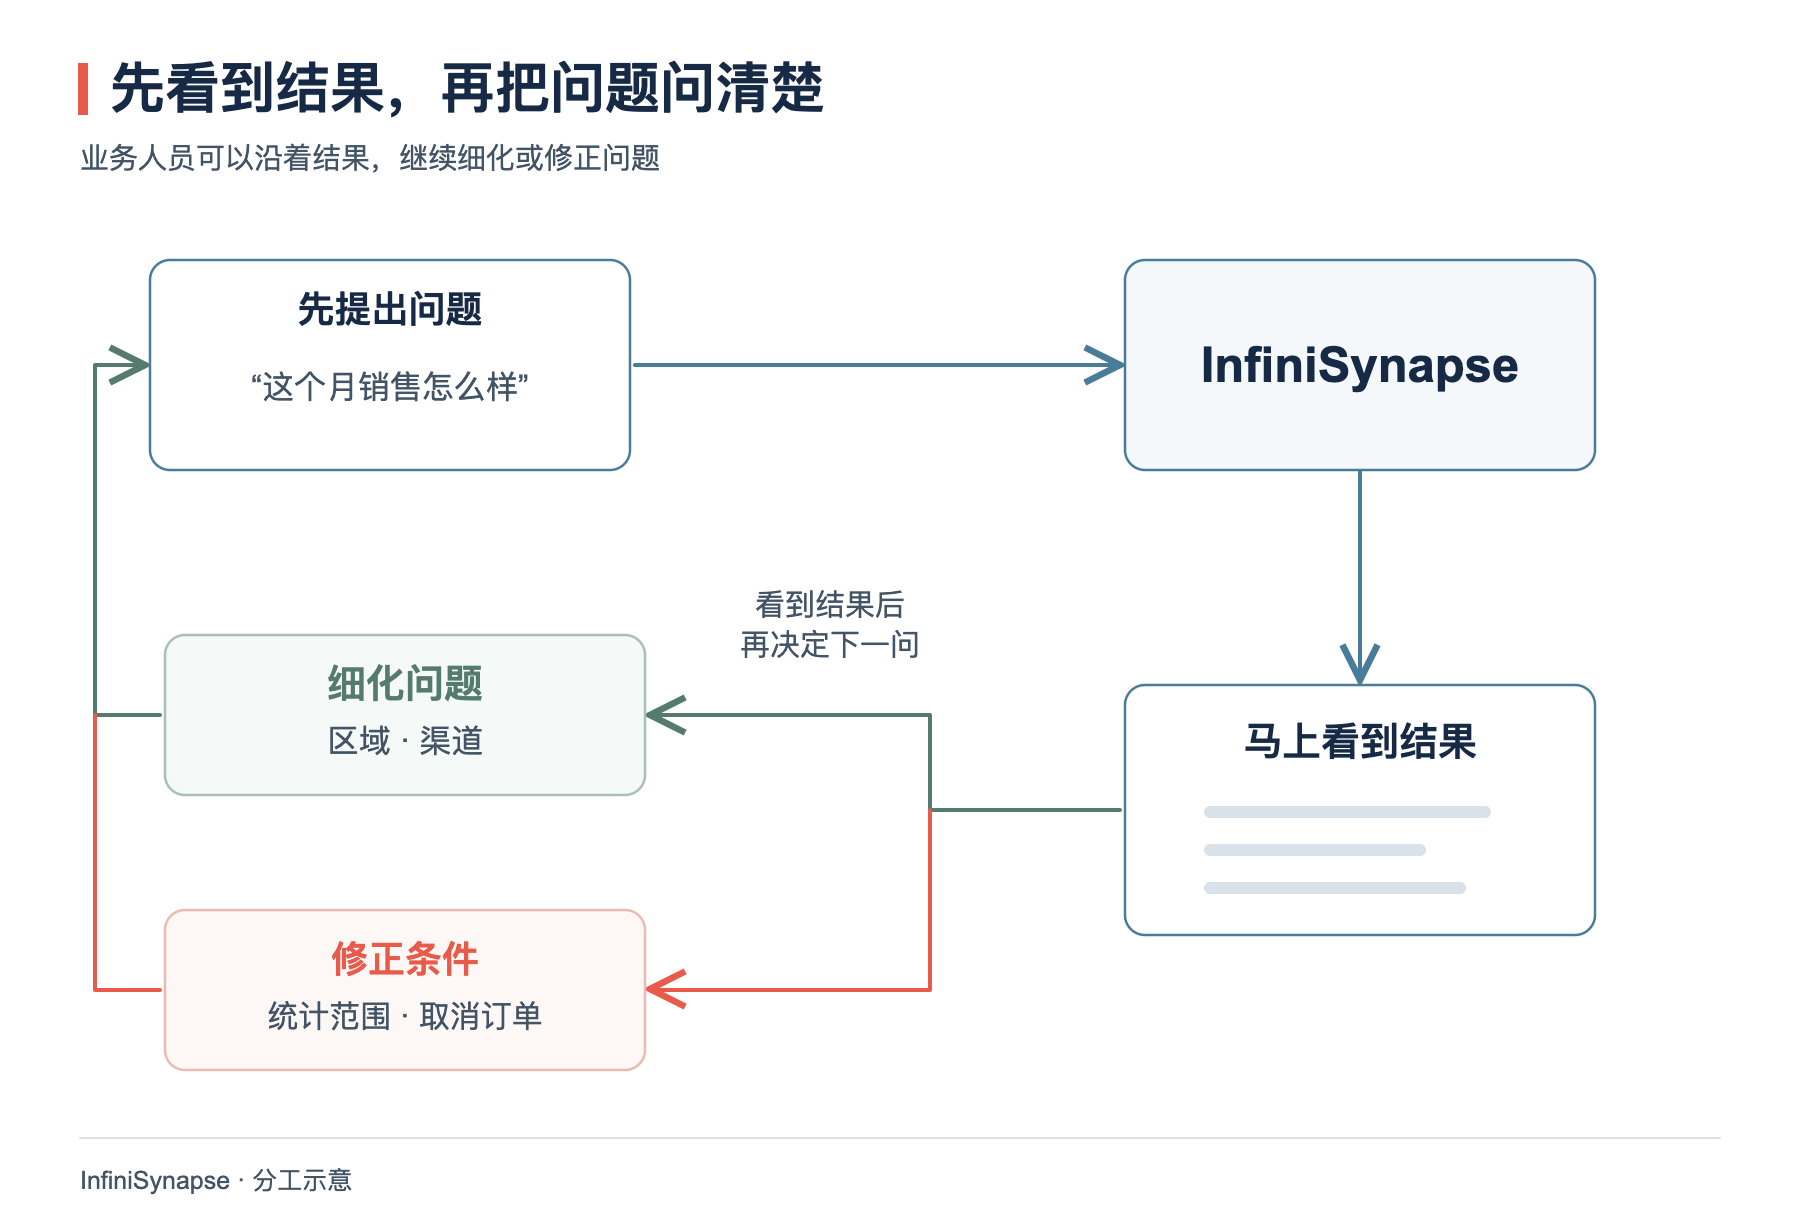
提问过程示意:业务人员看到结果后,沿着细化问题或修正条件两条支路继续提问。
系统的准确率也可以按业务需要设定。比如,业务方提出“我就是要 39% 的准确率”,InfiniSynapse 可以提供这样的能力。这里的准确率,指约定业务问题中回答正确的比例。业务范围、什么算回答正确,以及如何验收,需要一起讲清楚,再检查系统是否达到设定要求。业务人员既能及时得到结果,也能知道结果达到什么标准,系统才有了可用、可信的基础。
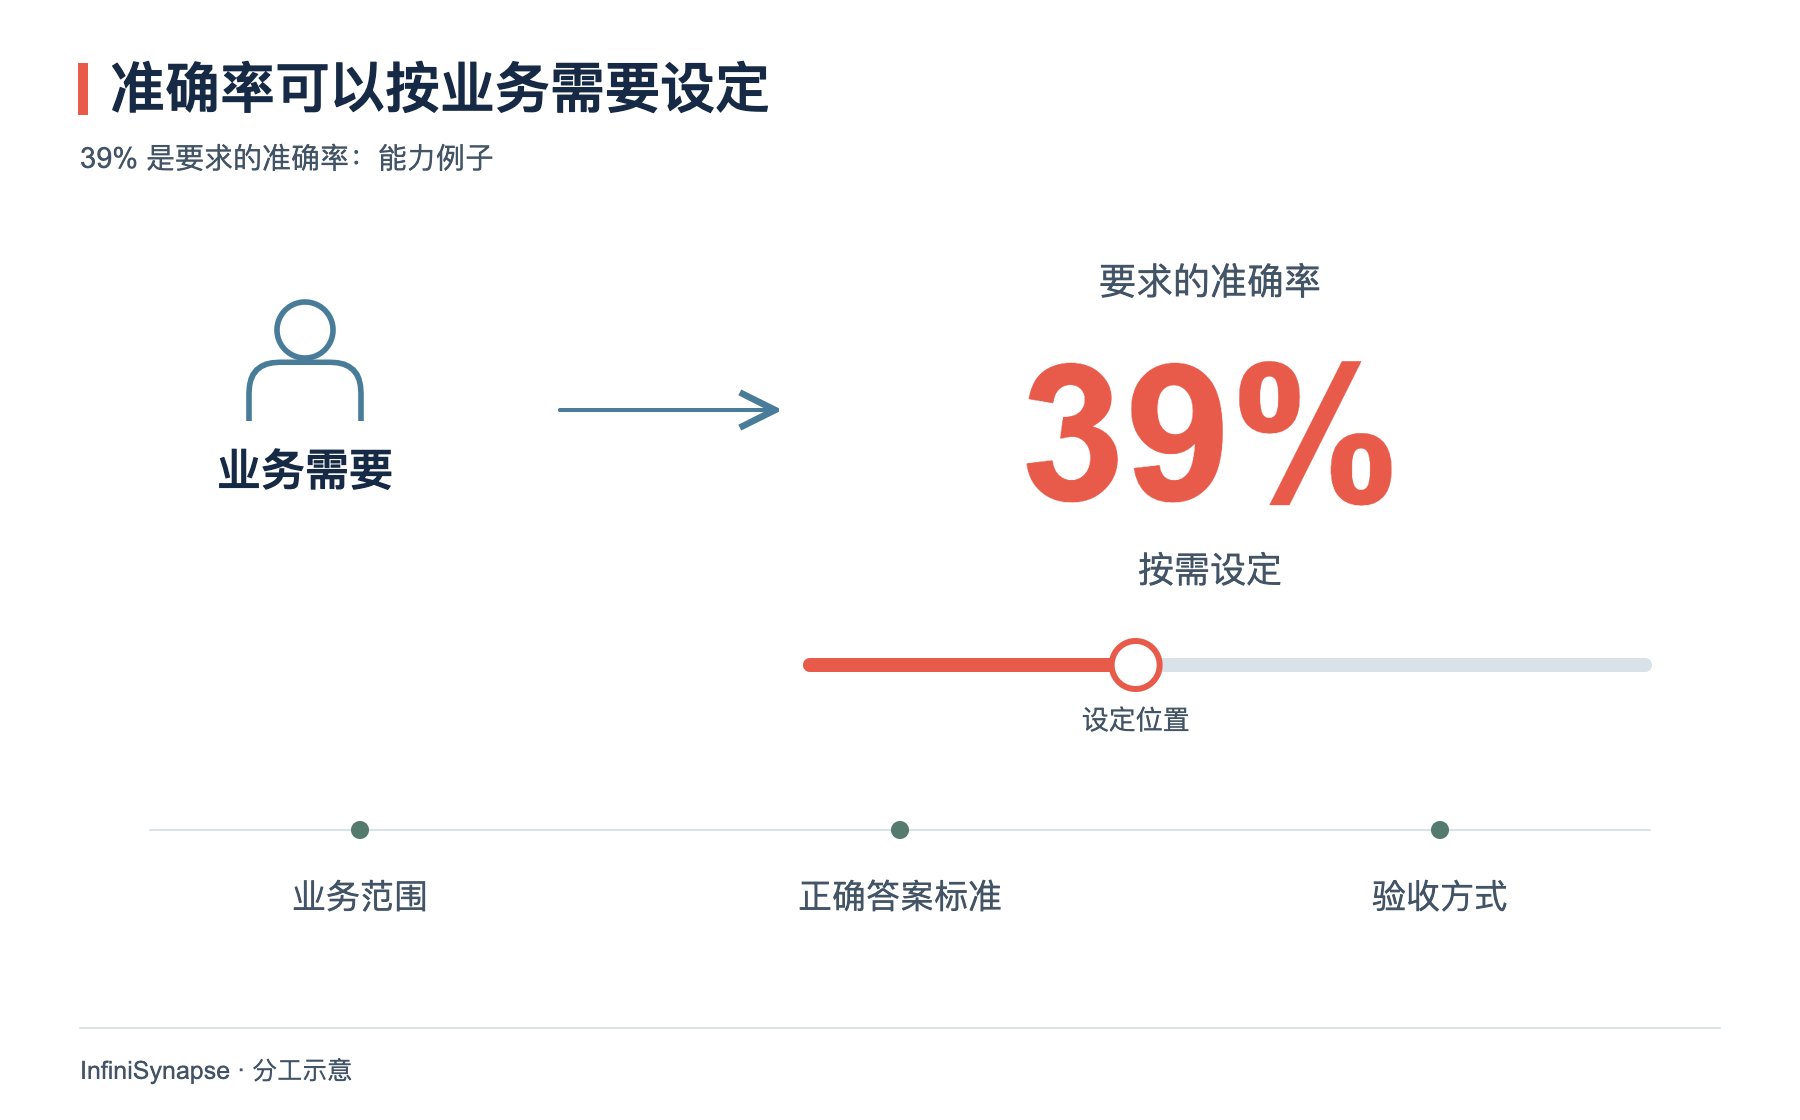
准确率设置示意:控件标记位于 39%,下方列有业务范围、正确答案标准和验收方式。
业务人员因此多了一项日常工作:看结果、判断哪里需要细化,并把业务上的疑问及时带回分析过程。他对问题的理解能够立即进入下一次提问,分析也就能随着业务判断继续推进。
分析师:审核和冷启动成为主要工作
当业务人员可以自己取数,分析师原来反复写查询、出报表、解释同类问题的工作会减少。他的主要精力转向审核和冷启动,维护 InfiniSynapse 自动化学习业务的能力。冷启动在这里指系统刚接触一项业务时,怎样让它先学会一批可靠的业务知识和分析方法。
还是以月度销售为例。分析师可以从已有报表和业务后台中选出问题与可靠答案,把统计时间、业务范围和筛选条件说明白,让系统尝试复现。结果不一致时,分析师需要判断差异来自哪里:退款是否扣除,取消订单是否排除,地区是按客户所在地还是成交门店划分。找到原因,再让正确的处理方法进入后续学习。
日常审核也有具体内容。InfiniSynapse 的企业版已有把表与字段含义、指标定义、分析案例等变更交给人工审核的做法。分析师可以查看系统提出的新旧说明,判断是否接受,或者指出需要修改的地方。这样,系统在分析中学到的内容,有人负责检查能否继续使用,错误理解也能得到纠正。
其次,分析师要留下更深入的业务理解和分析方法论,也就是面对一类问题时,怎样拆解、比较和查找原因。销售下降时先按哪些维度拆开,哪些指标需要并列观察,什么情况需要进一步核对,这些经验都可以随分析案例保存下来。后来有人换一个月份、换一种问法提问,系统仍能复用其中适用的做法。分析师处理过的问题,因而可以帮助后续更多次提问。
业务专家:在使用中留下业务定义
过去,业务专家经常在项目启动时集中解释业务,确认指标,再由分析师和技术人员把这些说明写进文档、查询或模型。业务发生变化以后,专家还需要再次解释,同一条规则有时会在不同项目里讲很多遍。
使用 InfiniSynapse 后,业务专家会变得更重要。分析过程会不断遇到需要他来判断的问题:一笔订单处于什么状态才算完成,新增费用从哪个期间开始扣除,销售和财务对收入的定义为什么不同。这些判断决定了数据结果在业务上是否成立。
专家可以在看结果、纠正口径的过程中完成这项工作。比如,讨论月度销售时,他指出销售部门看的是已经完成交易的金额,财务部门还要看实际到账。系统就有了需要区分的业务定义。相关知识经过确认、审核后留下来,后续分析可以按相应口径继续计算,减少反复解释。
这里留下的是计算规则和适用条件。只保存某个月的销售数字,不能说明下个月该怎样取数;知道数字怎样计算、适用于什么问题,才有复用方法的可能。业务专家每次使用系统时补充的解释和修正,都可以成为后续分析的知识来源。他参与得越深入,系统对实际业务的理解才越有机会跟上变化。
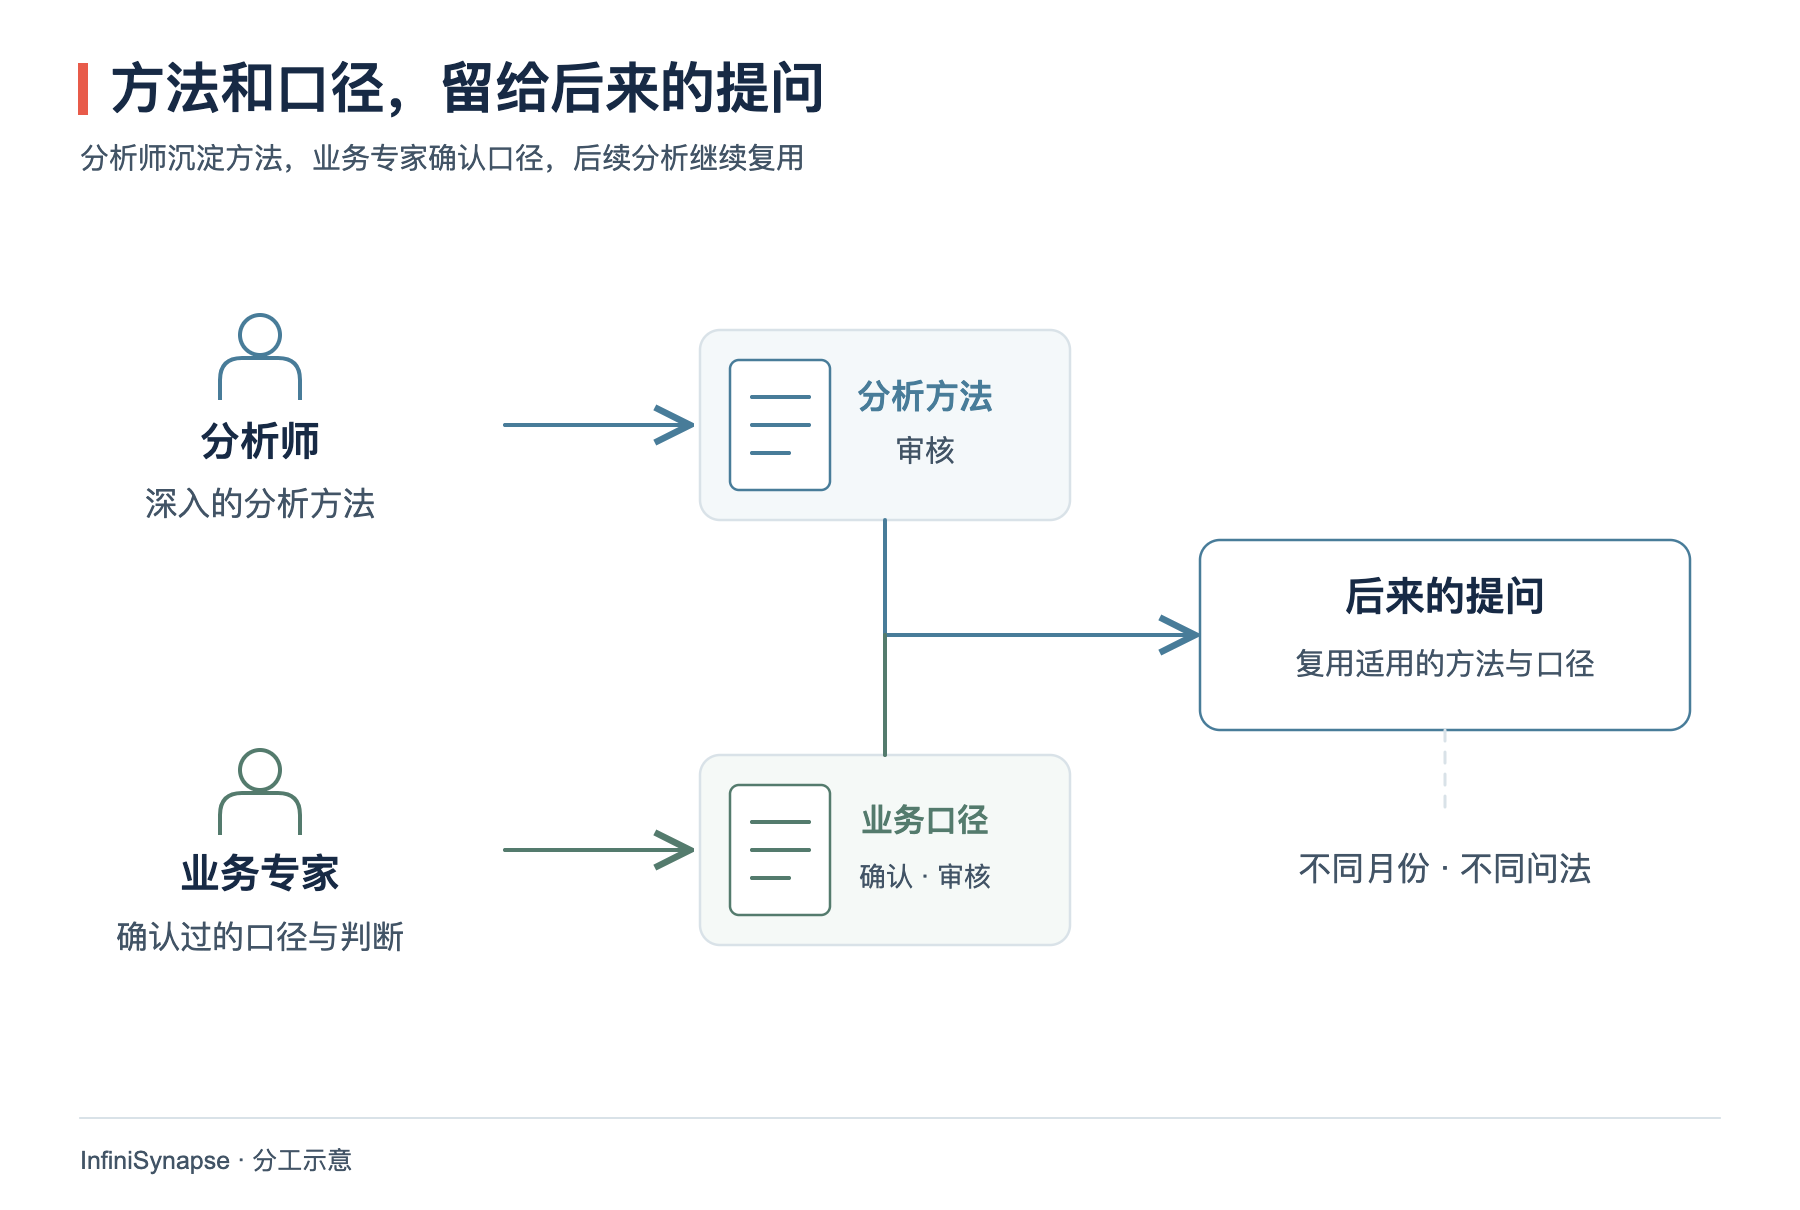
知识复用示意:分析师的方法与业务专家确认的口径经过审核,连接到后来的提问。
实习生:通过准备题目参与业务学习
在传统的分工里,实习生即使能够整理报表、核对数字,也很难独立讲清底层数据库与完整的分析逻辑。要把这些内容变成系统可用的知识,仍然需要专家、分析师和技术团队继续整理。
InfiniSynapse 给了他们一种更容易参与的方式。几个实习生可以从已有报表、业务后台或经过确认的问答中整理题目,记录问题、答案和对应的统计条件,再让系统去做题。遇到题目含糊、答案对不上,便把问题交给分析师和业务专家核对。
例如,一道“本月某区域净销售额是多少”的题,需要说明区域、时间以及退款的处理方式。系统为复现答案,要逐步弄清订单和退款分别存在哪里、相关库表如何关联、字段在业务中是什么意思,以及净销售额应该怎样计算。通过几个实习生参与准备、系统做一些题目,业务逻辑、底层数据库的业务含义和库表结构,以及分析方法论,就可以逐步学下来。
实习生负责把题目与答案准备清楚,系统承担做题中的探索和知识整理,专业人员负责关键判断与审核。这样的分工让已有业务成果能够用于启动学习,也让准备工作可以由更多人参与。学到一类问题的处理方法之后,系统才有基础去回答时间、区域或条件有所变化的新问题。
数仓与建模人员:工作重心移向系统稳定
传统数仓和建模人员需要把分散的数据整理成适合分析的结构,处理表之间的关系,再写明库表和字段的含义。业务增加一种分析需求,可能就要增加数据加工、调整模型,并维护相应说明。业务人员最终看到的报表,背后有大量这样的建设工作。
在 InfiniSynapse 这套做法里,数仓与建模人员离开了先建仓、再手写字段含义的工作路径,不再承担这一整套前置建设与处理工作。系统通过做题、分析和纠错,逐步学习库表结构、业务含义和分析方法,人工则在关键处确认和审核。原来需要先集中整理的知识,可以随着实际问题持续积累。
这部分人员的工作更多转向保证系统稳定。业务问题不断变化,数据需要持续可查,已经学到的方法才有机会反复使用,后续分析也才能接着做下去。
IT 运维与研发:稳定地向 Agent 提供查询能力
过去,研发人员大量参与取数、加工和数仓建设,运维人员负责让相关数据库、任务和服务运行下去。引入 InfiniSynapse 后,IT 运维与研发同样离开先建仓、再手写库表字段含义的路径,更多地把系统稳住。
查询的使用方式也在变化。DataEngine 是 InfiniSynapse 里承接查询的数据引擎;Agent 是代替人向这个引擎要结果的程序。业务人员直接提问之后,Agent 会根据分析需要请求数据,再继续处理结果。业务人员看到结果后追加问题,同一项分析也可能需要多次查询。随着使用增加,DataEngine 承接的查询量会越来越大。
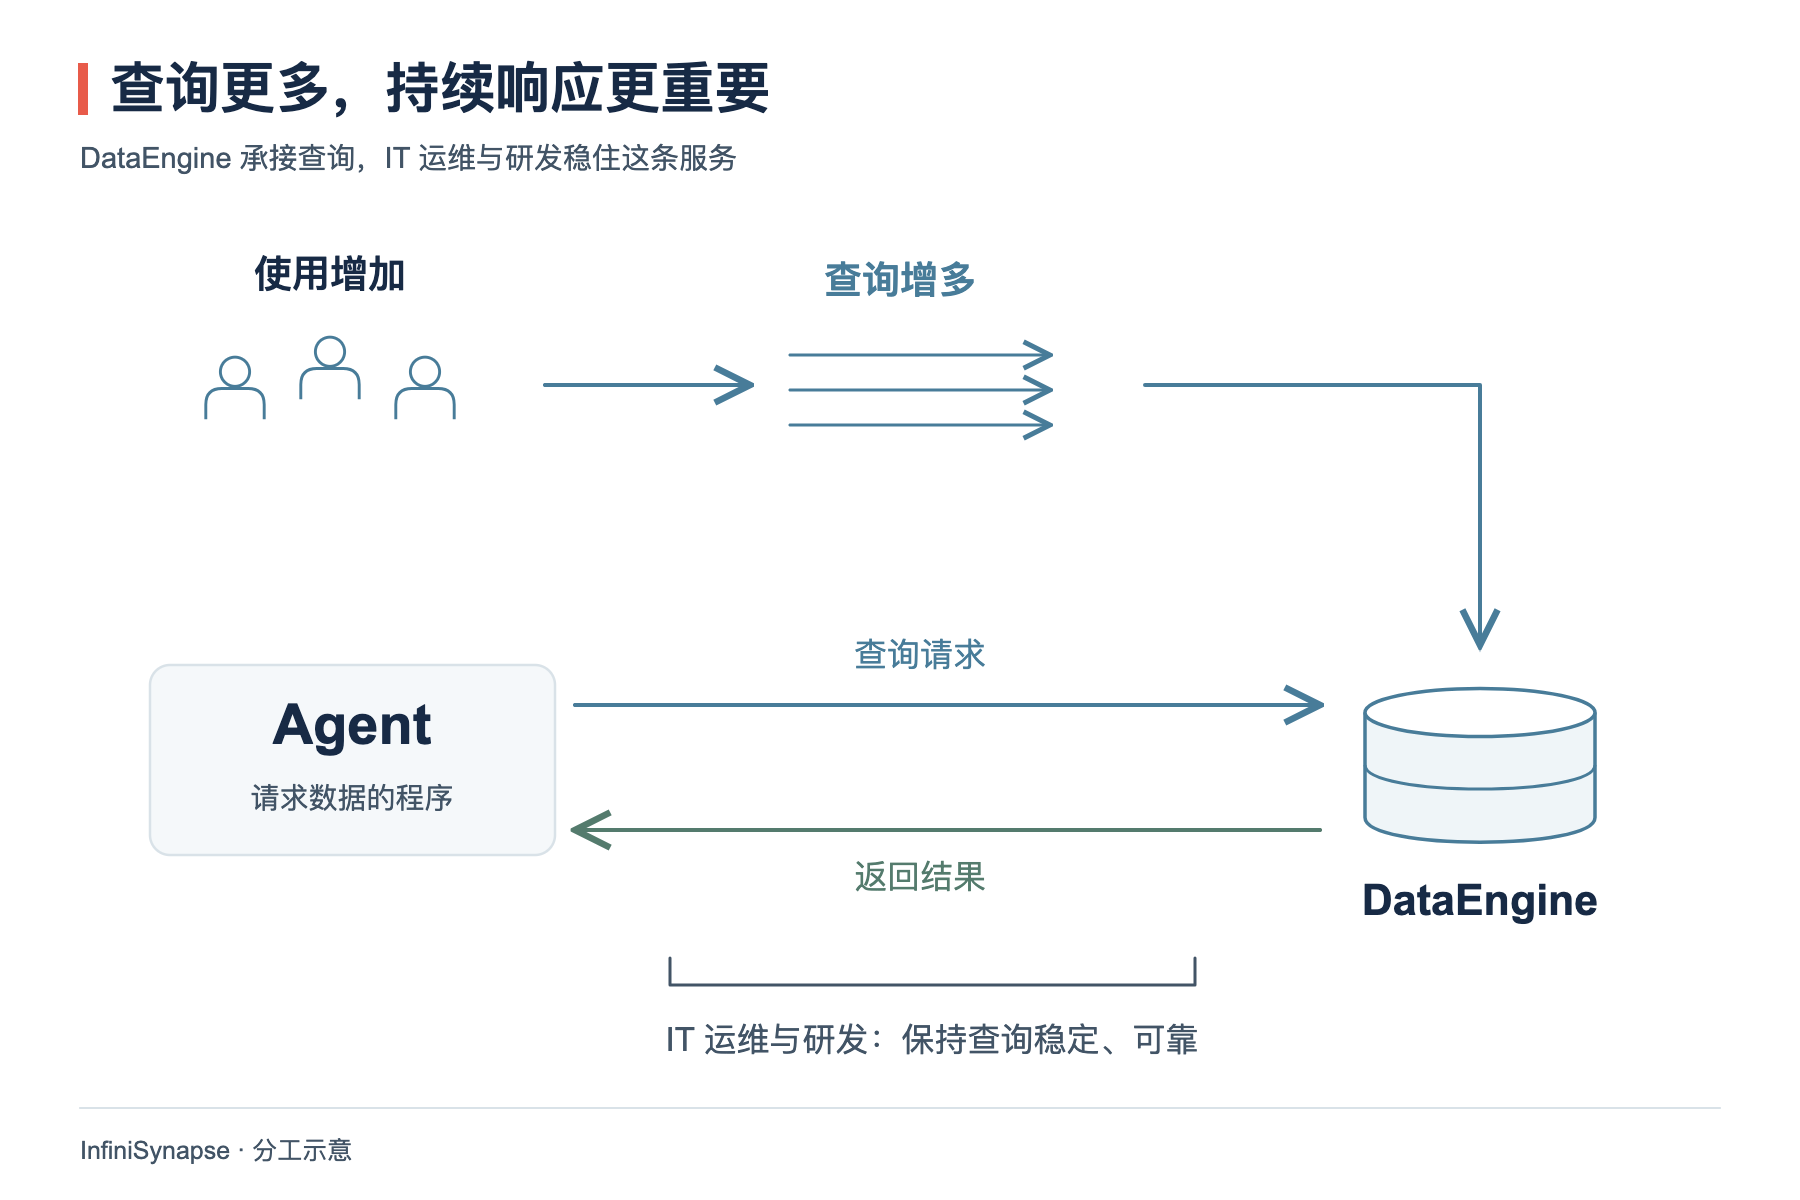
查询服务示意:使用增加带来更多查询,Agent 请求数据,DataEngine 返回结果,IT 运维与研发维护查询服务。
对 IT 运维与研发来说,稳定、可靠地向 Agent 提供查询能力因而变得更重要。查询变多时,系统能否持续响应,故障能否及时处理,都会影响业务人员能否继续分析。分析师审核通过的方法、业务专家确认过的定义,都要通过实际执行查询才能得到新的结果,底层服务的稳定性也就成为这套分工能够运转的基础。
业务人员直接用数,分析师维护学习与审核,业务专家持续补充判断,实习生参与准备题目,数仓、建模和 IT 团队把系统稳住,构成了新的日常工作关系。数据治理能否持续运转,越来越取决于业务经验能否反复用上,以及查询能否持续可靠地执行。