我以前说过:模型决定了你的智力,记忆决定了你是谁。放到日常使用中,还可以补上一句:Agent 决定了你能做什么。
不同 Agent 擅长的事情各不相同。有的适合研究,有的适合写代码,有的方便在手机上随时交流,有的可以操作本地电脑。我们会根据任务选择工具,也会随着产品变化不断尝试新的 Agent。但在这个过程中,我希望有一件事能够延续:它们知道我是谁,知道我已经确认过什么,知道我们过去怎样合作。
这也是我们做 Sparse Agent Memory 的出发点。把已经积累的偏好、项目约定和经验保存下来,让你用的所有 Agent 都能在获得授权后接上它,继续理解你的要求。
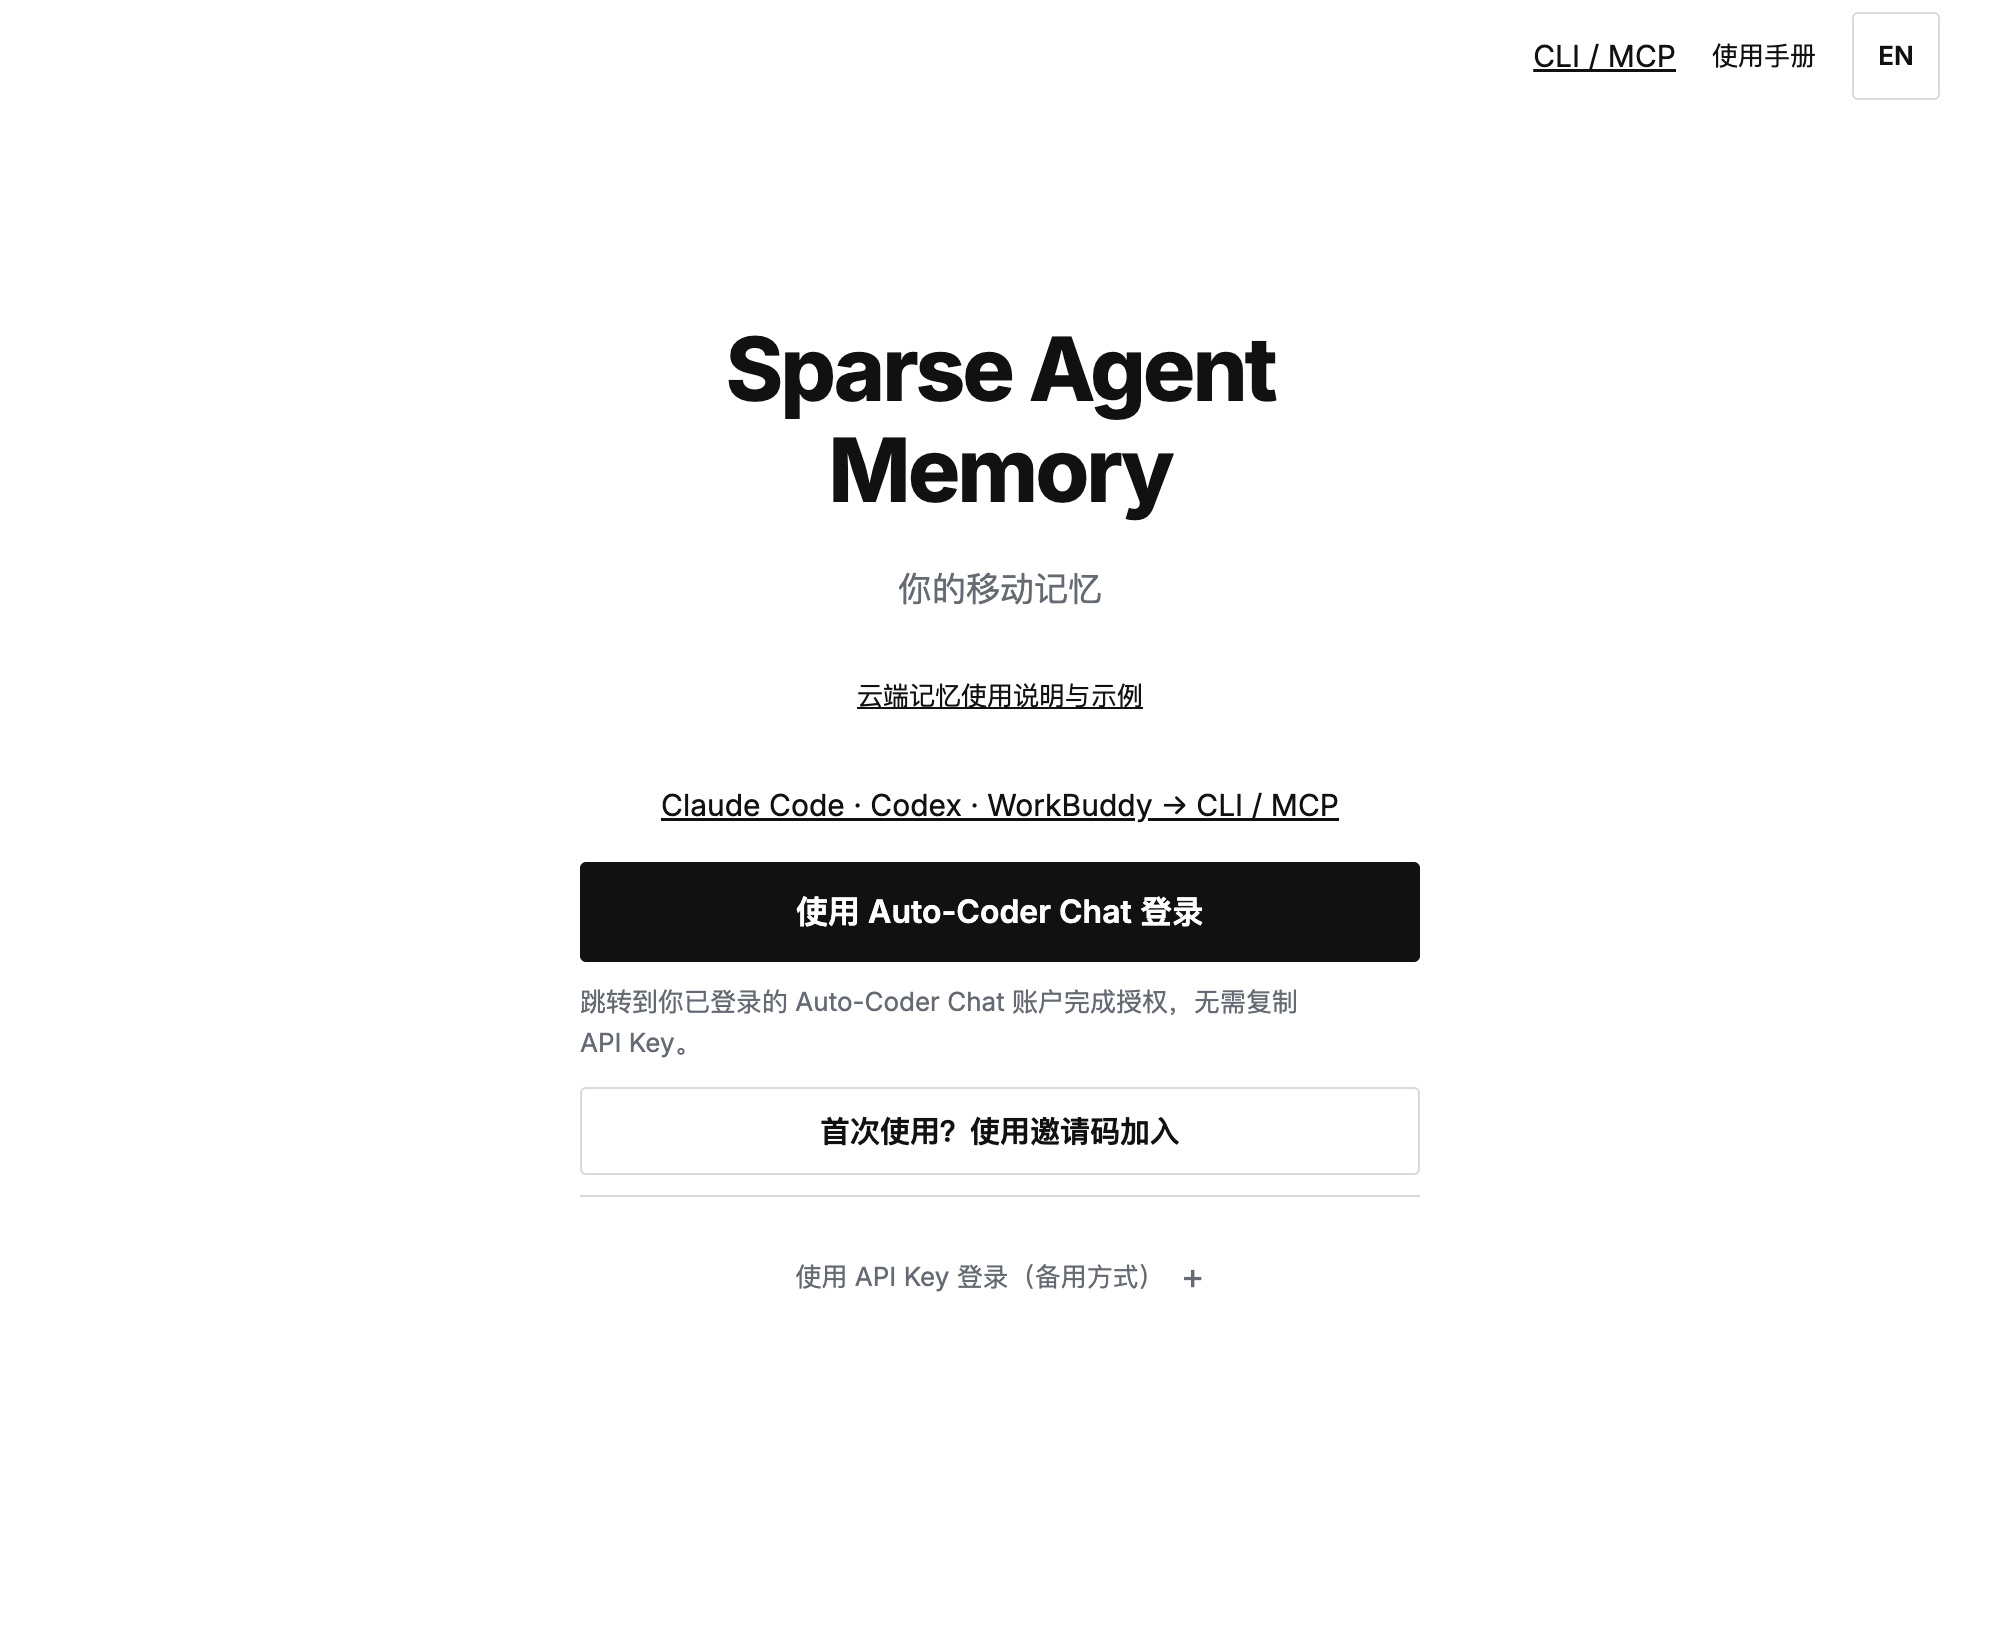
Sparse Agent Memory 首页:你的移动记忆。通过 Auto-Coder Chat 登录后,可以管理自己的云端记忆。
和 Agent 合作久了,积累下来的内容其实很具体。文章要写成正常文章,少一些口播味道;项目里有已经确定的做法,开始工作前应该先查;某个问题以前处理过,下次遇到时可以参考;一条要求后来改了,后续工作应当使用新的约定。
这些内容是你花时间形成的工作习惯和判断。每次换一个 Agent,都重新交代一遍,成本会越来越高。更麻烦的是,解释得少一点,它就可能沿用一套与你不相符的默认做法。你本来想试试新的能力,最后却花了很多时间重新磨合。
因此,我认为,面向跨设备、跨产品的长期使用,记忆一定要 SaaS 化,一定要云端化。SaaS 在这里的意思很简单:把记忆做成可以独立连接的云端服务,让获得授权的 Agent 随时查询和补充。无论它运行在谁家的云端,还是我的本地电脑上,都可以接入这套记忆。
我今天使用 Grok Bot,明天换到 WorkBuddy,之后再让本地的 Agent 接着处理事情,已有的偏好和项目经验应该能够继续使用。这样,我尝试新工具时,就可以把更多精力放在它擅长的事情上。此前积累的合作经验有一个持续保存的位置,新的工具也有机会用上它。
写这篇文章时,我们实际登录了 Sparse Agent Memory,在已有项目中用自然语言查询写作要求和记忆接入方式。返回的记录里,能找到此前保存的文章协作约定,也能找到 Grok Bot 使用这套记忆的约定:开始工作先查询,再读取相关来源,只保存已经确认的内容。
此前和另一个 Agent 确认过的事情,现在换到网页入口,仍然可以查到。后续换一个获得同一项目授权的 Agent,也有了继续使用这些记录的基础。你可以自己打开项目,输入日常语言的问题,检查哪些过去的约定适用于眼前这件事。
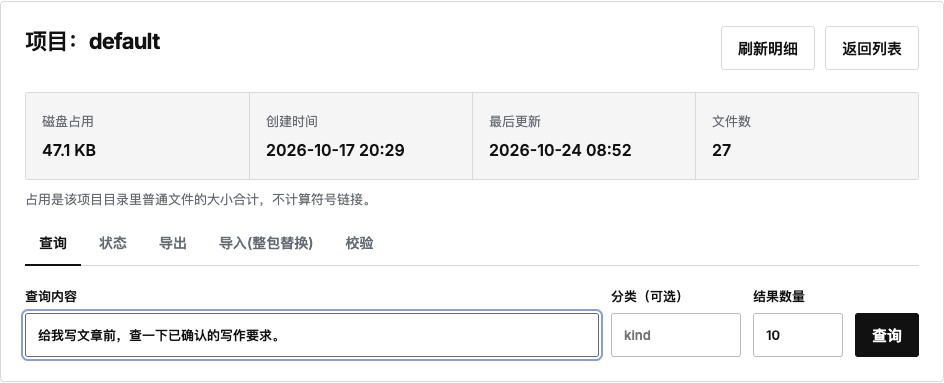
项目查询界面。输入框展示写作要求的查询示例;同一页面还提供状态、导出、导入和校验入口。
把这套记忆交给其他 Agent 使用,也有明确的接入方法。能执行命令的 Agent 可以使用 CLI;支持工具连接的客户端可以通过 MCP 查询、读取和保存记忆;Skill 则告诉 Agent,什么时候应该查、怎样使用查到的内容、哪些经验值得保留。目前公开指南已经列出了 Claude Code、Codex 和 WorkBuddy 的接入方法。WorkBuddy 可以配置记忆工具,也可以导入对应的 Skill 包。接入指南
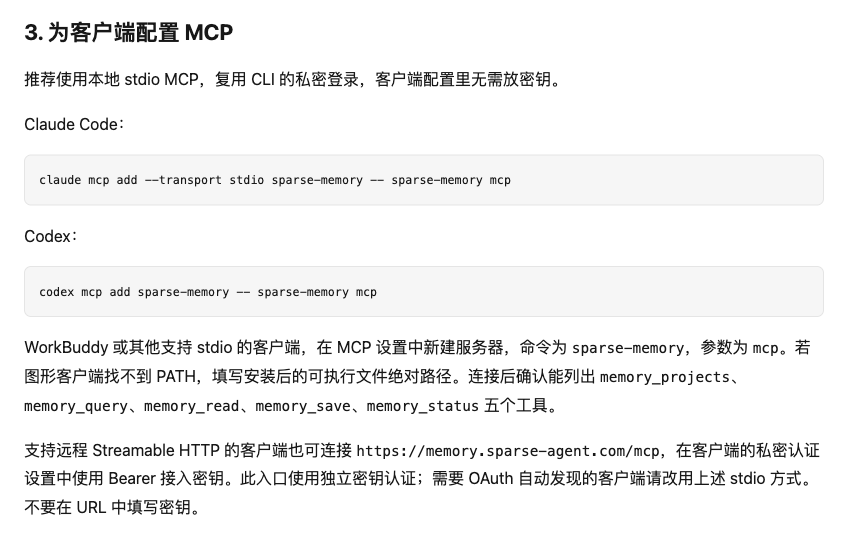
官方接入说明:Claude Code、Codex 和 WorkBuddy 可以通过记忆工具访问获得授权的项目。
对于我使用的 Grok Bot,已有记忆中保存了通过 CLI 使用服务的约定。其他云端 Bot 是否能接入,要看它是否支持相应的命令或工具接口。对具备这些条件的 Agent,把已有记忆接进去,就能让它在当前任务中查询过去的偏好、决定和经验。
举个使用场景:假设我在 Grok Bot 里确认了一条写作要求,产品文章要把用途和使用方式说清楚,不要写成短视频口播。以后让 WorkBuddy 帮我整理一篇产品稿时,可以先让它查询这条要求,再结合本次素材写作。如果这次又确认了一个值得长期保留的表达方式,就把它补充进去,供后续任务使用。
这个例子里,用户的积累有了连续性。今天使用的 Agent 可能换了,任务所在的设备也可能换了,但以前花时间确认的要求仍然用得上。随着工作继续,新的经验又会进入同一套记忆。每次合作,都有机会帮助下一次合作。
当然,要让这种连续性实际发生,还需要 Agent 在任务中使用记忆。接上服务以后,应该先查询与当前任务有关的内容,读清原来的记录,再结合眼前情况处理工作。任务结束时,把新确认的要求、有效的做法和需要避免的错误保存下来。普通对话和工具的私人历史不会自动上传,哪些内容适合长期保留,需要有明确的选择。
记忆也需要持续维护。项目方案变了,要说明新的决定从什么时候开始适用;旧经验只在某些条件下有效,也要保留这些条件。否则,保存得越多,后续工作越容易把不同时间的要求混在一起。云端服务的价值,还包括让用户有一个可以查询、检查和备份这些内容的入口。使用手册
共享范围同样需要由用户决定。个人写作偏好可以交给多个写作 Agent,某个客户项目的资料则只供获准参与的 Agent 使用。Sparse Agent Memory 按账号和项目管理记忆。为不同工具授权时,可以分别选择它能访问的项目、只读还是读写,以及有效期;停止使用某个工具时,也可以撤销它的密钥。
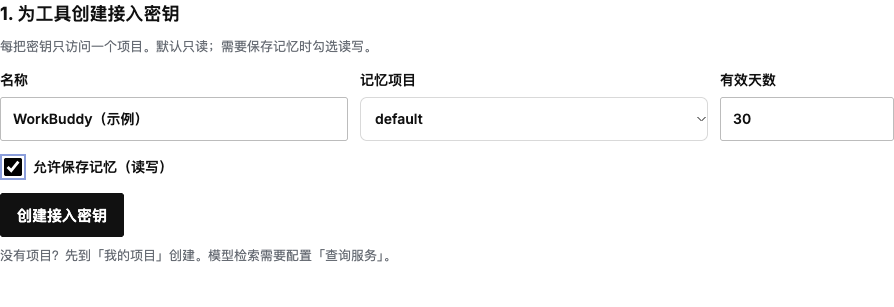
接入设置:为工具选择项目、读写权限和有效期。图中为 WorkBuddy 的填写示例,未创建密钥。
这让“让所有 Agent 都是你”有了一个实际可用的范围:让它们在各自负责的工作里,延续你允许它们使用的那部分经验。用户可以导出备份,检查保存了什么,再决定把哪一部分交给新的工具。记忆的积累和使用,都应当掌握在用户手里。
我所说的随时随地的数字分身,就是这种合作的延续。出门时在云端 Bot 里讨论一个想法,回到电脑前用另一个 Agent 继续整理,换到本地环境处理具体工作时,相关背景仍然可以查询。不同 Agent 保留各自的能力和判断,同时参考同一套经过授权的偏好、约定与经验。
模型会继续进步,Agent 也会不断出现新的选择。我希望用户每次换工具时,已经积累的经验都能跟着自己走,让新接入的 Agent 从理解这个人的要求开始工作。